

字节跳动发布SeedRealtime音视频全双工大模型,已上线豆包
字节跳动 Seed 今日推出原生音视频全双工大模型 SeedRealtime,该模型采用统一架构,原生融合音频、视频与文本,支持在连续的多模态信息流上实时交互,实现“边看、边听、边说”的体验。
SeedRealtime 的核心突破包括:
- 音视频联合理解:原生支持声音、画面与时序信息深度融合,能结合场景消解同音词歧义,并理解视觉中的时序指代。
- 主动交互能力:具备持续环境感知与主动表达,能察觉画面状态变化(如关键目标出现)时主动提醒,并可调用工具融入表达。
- 流畅交互节奏:实时感知对话状态与交流节奏,自然接话、停顿与回应,同时具备抗干扰能力,能分辨旁人闲聊与背景噪声。
端到端人工评测显示,相比级联模型,SeedRealtime 的音视频对话节奏问题减少一半,模型对说话时机把握更自然,单次对话完整顺畅交流的概率明显提升。
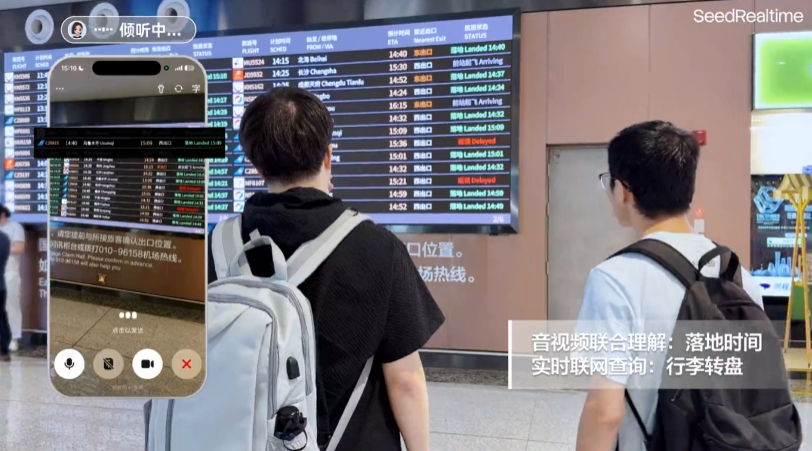
目前,SeedRealtime 已在豆包 App 全量上线,用户更新至最新版本后,在对话框选择“打电话”进入视频通话界面即可体验。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。