

AI SSD推动大模型推理存储范式转向词元(Tokens)实时链路
算力、网络、内存与存储开始围绕每个词元(Tokens)协同工作。过去两年,AI基础设施的竞争主要聚焦于GPU数量、芯片算力、HBM带宽和高速网络。然而,随着大模型进入长上下文、复杂推理和多智能体阶段,决定系统有效词元(Tokens)产出的因素变得更加复杂。GPU仍是算力核心,但其实际利用率越来越依赖模型权重、KV Cache和MoE专家能否在正确时间抵达正确的计算节点。AI Infra正从“堆叠计算资源”转向“协同计算、网络、内存与存储数据路径”的新阶段。
月之暗面的Mooncake与NVIDIA的CMX是这一变化的两个代表性信号。月之暗面从大规模推理软件架构出发,将集群中分散的CPU、DRAM、SSD和NIC组织为可调度的KV Cache资源;NVIDIA则在Vera Rubin基础设施中建立专门的Pod级Flash上下文层。两者尺度和实现方式不同,但共同指向一个趋势:推理状态正成为AI基础设施中的一级资源,存储也开始进入词元(Tokens)生成的实时主链路。
Mooncake的产业意义不仅在于为Kimi构建了新的推理服务系统,更在于改变了大模型基础设施对“数据”的组织方式。传统推理节点往往将GPU、CPU、DRAM和本地SSD视为服务器内部的固定资源,KV Cache主要跟随请求和GPU实例存在;一旦缓存被驱逐或请求迁移,已完成的Prefill计算可能失去复用价值。上下文越长,重复计算和昂贵GPU资源的浪费就越明显。
Moonshot AI与清华大学发表于USENIX FAST ’25的Mooncake采用以KV Cache为中心的分离式架构,将Prefill与Decode部署在不同资源池中,并把GPU集群中未被充分利用的CPU、DRAM、SSD和NIC组织成分布式KV Cache池。中心的Conductor不再仅根据GPU负载分发请求,而是结合KV Cache分布、缓存命中、节点负载以及TTFT、TBT等服务目标,决定缓存复用、Prefill执行和Decode调度[1]。
Mooncake的请求流进一步说明了这种变化:可复用的Prefix KV Cache先被送至合适的Prefill实例,新增KV Cache随模型各层计算持续生成,再与Prefill计算重叠,异步流送到目标Decode节点;缓存到齐后,请求才进入连续批处理。Mooncake Store负责KV块的放置、复制、淘汰和生命周期管理,Transfer Engine则通过RDMA、多NIC带宽聚合与拓扑感知路径选择连接不同计算和存储层[1][2]。推理系统由此从“给GPU喂数据”转向“围绕Tensor生命周期编排整条数据路径”。
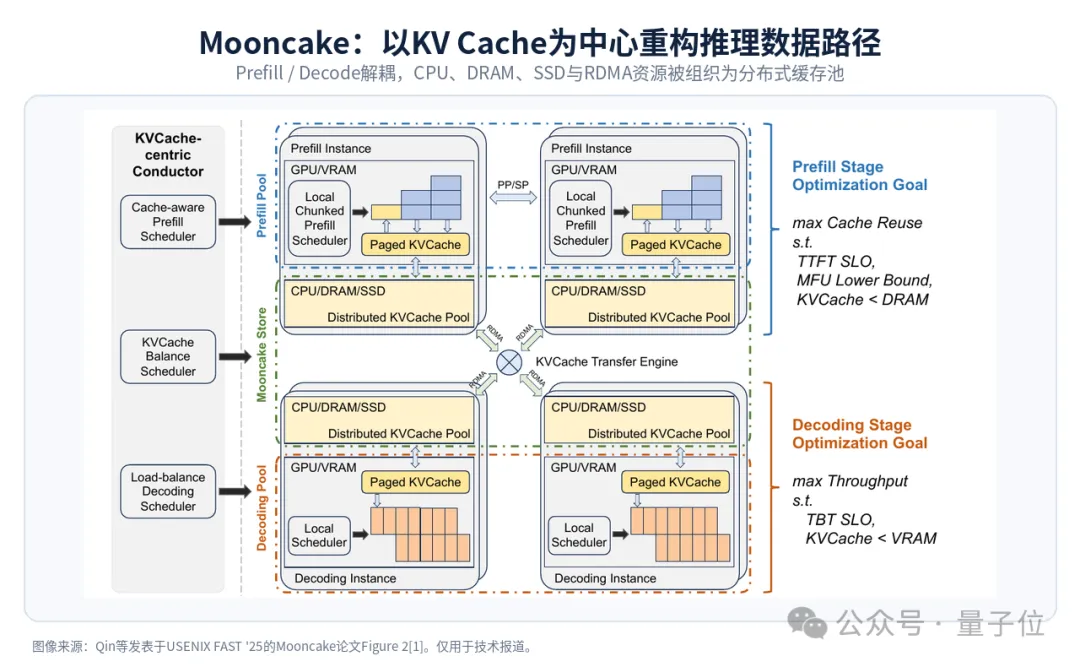
△Mooncake以KV Cache为中心的分离式推理架构:Prefill与Decode资源池通过Mooncake Store、RDMA传输引擎和全局调度器协同工作。
Mooncake论文将这一思路概括为“用更多存储换取更少计算”。根据论文披露,在真实请求轨迹和不同TBT约束下,Mooncake相对于所比较的基线系统提高了59%至498%的有效请求承载能力;论文发表时,其生产系统已运行于数千个节点,每日处理超过1000亿词元(Tokens)[1]。需要强调的是,这些数据反映的是缓存、调度、网络与计算协同后的端到端架构收益,并非某一块SSD的单盘收益。
更值得AI SSD产业关注的是,Mooncake当前官方文档已将DRAM与SSD/NVMe明确纳入多级缓存,并给出从内存向本地SSD卸载的路径,即将从内存淘汰的对象可在后台进入SSD,内存未命中时再从SSD回读;数据经过预注册缓冲区后,由Transfer Engine送往目标DRAM或VRAM[2][3]。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。