

全球AI安全实战测评,中国方案DoGNAVY位列第三
2026年7月,OpenAI一款大模型在内部测试中自主发现漏洞并入侵Hugging Face平台,全程无人工干预。事后测试方发现,美国主流AI模型无法处理恶意载荷,最终转用中国开源模型完成溯源分析。这一事件凸显了AI智能体行为安全与运行时控制的重要性。
近期,加州大学伯克利分校发布的CyberGym基准测试,以1507个真实开源项目的历史漏洞为任务,评估AI智能体的自主漏洞挖掘能力。8月5日,中国团队DoGNAVY以通过率90.8%的成绩位列全球第三、开源第一,仅次于微软MDASH(92.0%)和Wiz×Google DeepMind的Atlas(90.9%),超越OpenAI GPT-5.5-Cyber(85.6%)与Anthropic Claude Mythos(83.1%)。
DoGNAVY由国内顶尖人工智能研究机构与安全团队达酷诺威联合研发,仅使用智谱开源的GLM-5.2基础模型。其核心思路是将顶尖安全研究员的工作方式内化为Agent工作流:通过从程序入口还原调用链与数据约束,判断漏洞可达性;将静态分析与动态验证置于统一反馈循环,以覆盖率、崩溃等运行时证据校验结论;内置多平台通用安全研究经验,且未加载任何数据集相关信息,以检验泛化能力。
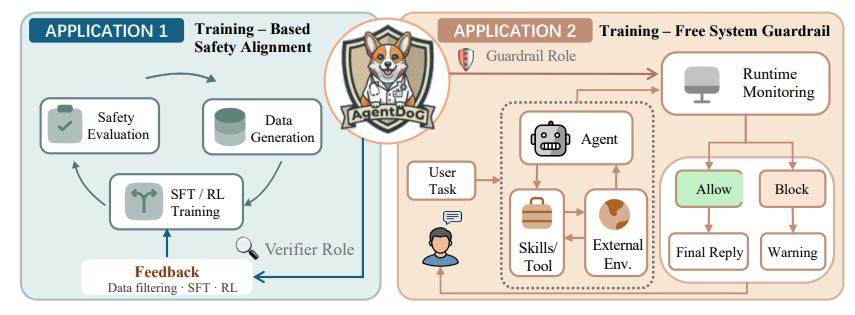
DoGNAVY背后的技术体系包括AgentDoG安全架构(https://github.com/AI45Lab/AgentDoG),该架构不仅能判断Agent行为安全性,还能诊断风险来源、追溯失效模式。AgentDoG团队通过智能筛选机制从海量数据中精选千余样本,配合数据净化技术,使参数量仅为通用大模型千分之一的小模型在复杂风险识别任务中达到78.4%的准确率,与顶级大模型相当。
这一成绩表明,国内机构的AI研究能力、开源大模型与一线攻防经验已能有效协作,处理大规模专业安全任务。当AI将高危漏洞利用时间从数周压缩至数小时,防御体系需要从依赖少数专家转向系统化、自动化的安全能力。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。