

至知研究院提出大模型可解释性新路线:拆权重,数据成本不到1%
大模型机制可解释性研究中存在一个矛盾:为理解已训练模型,研究者常需先训练一套新的稀疏表示。Transcoder、稀疏特征模块等方法会学习一组新内部单元,近似原模型某层或模块的计算,再通过保留或移除这些单元来寻找任务回路。这些方法推动了领域发展,但带来额外成本:新表示需要数据和优化,且若替代模块未充分复现原模块,后续分析可能同时解释模型行为和替换误差。
问题不止于训练成本。任务回路需找到可独立干预的内部计算:仅保留它们时相关能力仍存,移除时模型表现明显下降。训练型替代表示通常需针对不同模型、层和checkpoint分别拟合,使大规模系统性回路分析更困难。更理想的方案应同时保持原模型行为、提供可独立干预单元,并低成本从已有权重构造。
至知创新研究院(IQuest Research)与Safe AI Forum、牛津大学、斯坦福大学、清华大学的合作者提出新路线:不再训练独立替代网络,而是从现有预训练权重中直接“拆”出可干预单元。该方法名为稀疏权重分解(Sparse Weight Decomposition,SWD),将稠密权重矩阵分解为两个稀疏矩阵,二者共享的中间维度成为可独立评分、选择和消融的瓶颈单元,研究者可直接在权重上抽取任务回路。
论文地址:https://arxiv.org/abs/2608.03913
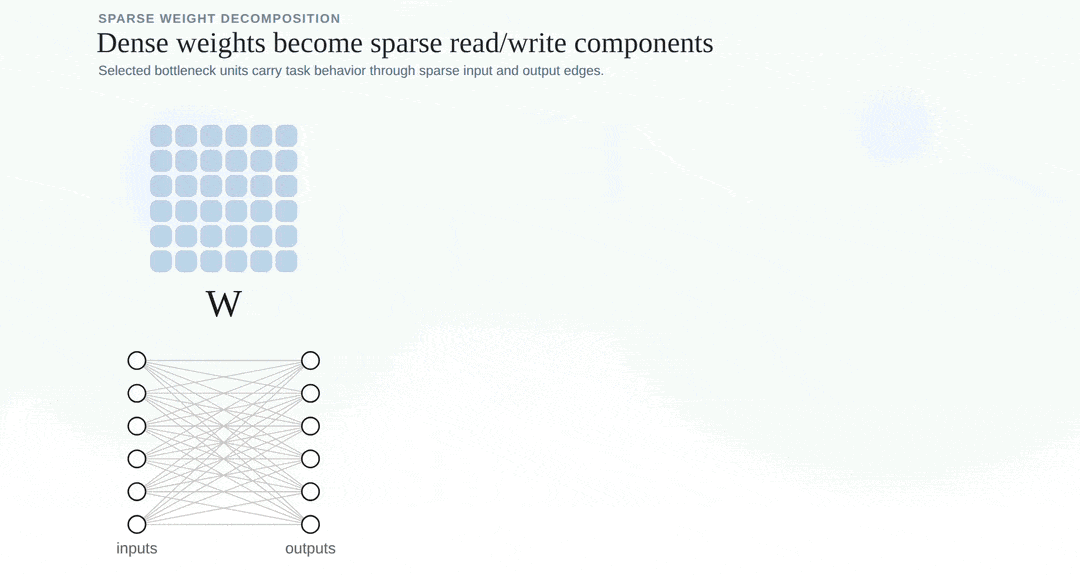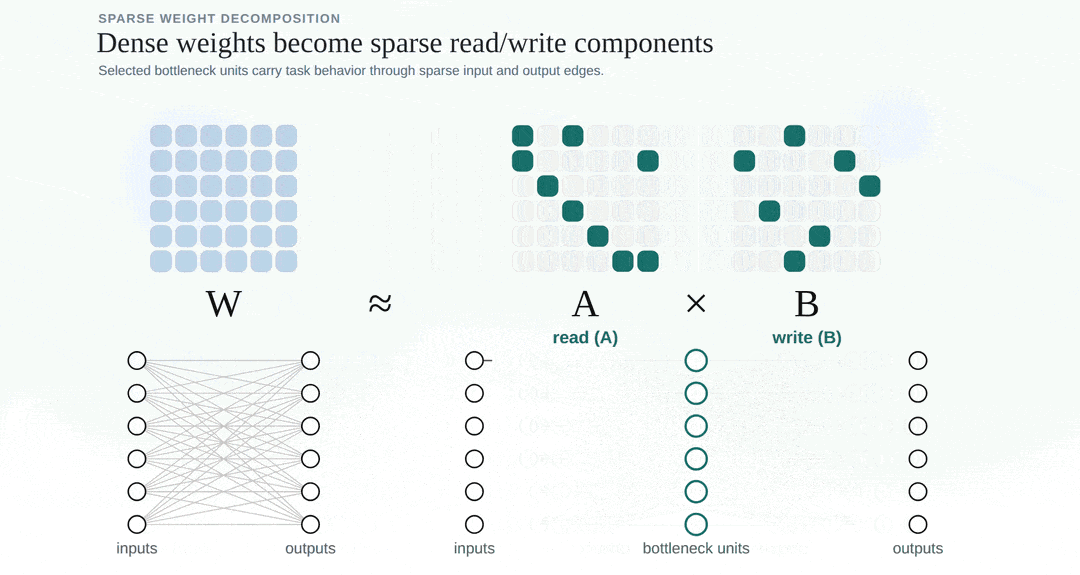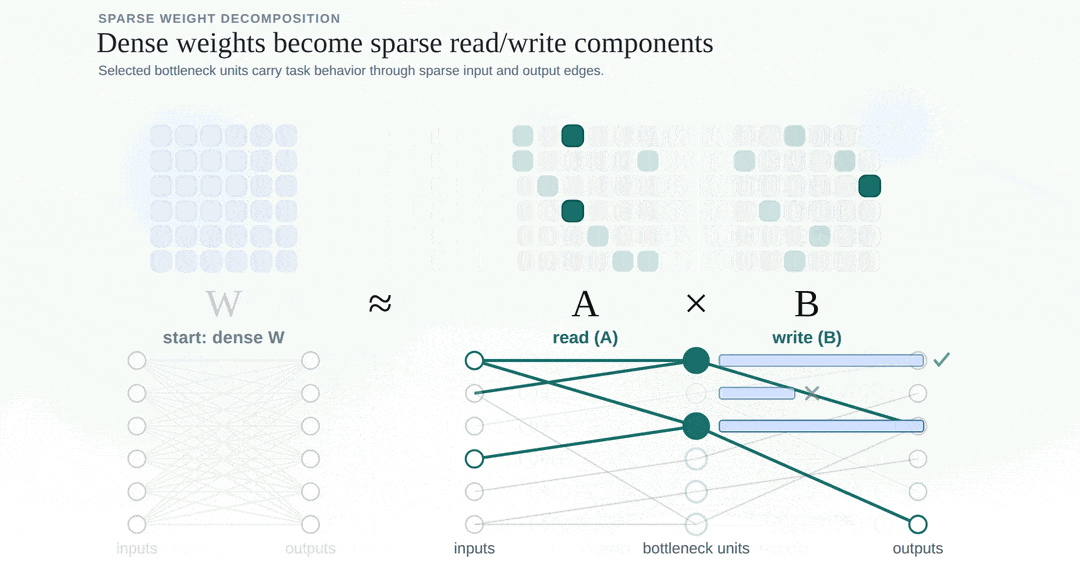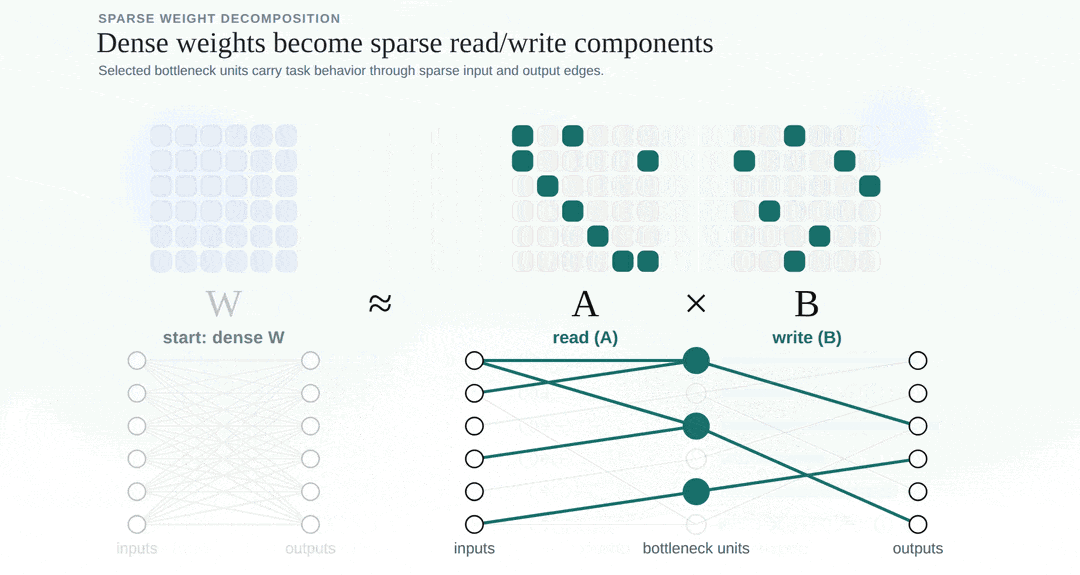
△SWD方法概览。预训练模型中的稠密权重被分解为两个稀疏因子,共享中间坐标成为可独立评分、选择和消融的瓶颈单元。
SWD的出发点简单:对于预训练模型中的稠密权重矩阵W,寻找两个稀疏矩阵A和B,使得A和B共享m个中间维度。第i个维度先通过A的第i列从输入中读出一个标量,再通过B的第i行写向输出,这样一列和一行共同构成一个瓶颈单元,即一条固定的rank-one读写路径。可将其想象为在密集交通网络中增加“中转站”:每个中转站只连接少量入口和出口,研究者不仅可看到路径的读写方向,还可单独关闭它观察模型行为变化。
难点在于大幅减少连接的同时保留原权重对模型激活的作用。SWD使用少量校准文本产生的层输入,优化分解前后的输出误差;求解过程中交替更新两个因子,通过硬阈值维持非零预算,并重新拟合保留的权重值。分解完成后,每个瓶颈单元可像稀疏特征一样参与任务归因、排序和消融,但无需再训练独立神经替代网络。
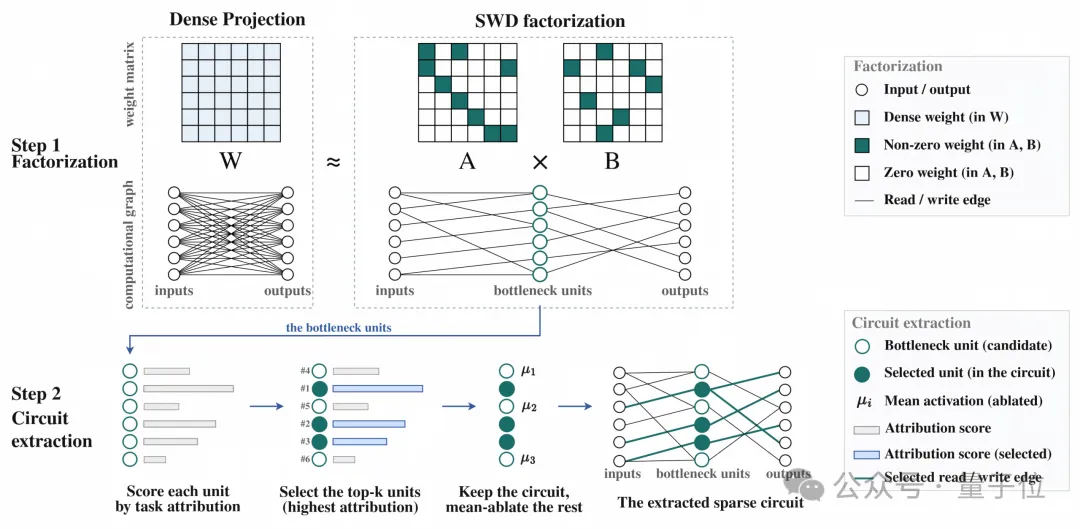
△从权重分解到回路抽取。Step 1将稠密权重分解为稀疏因子A和B;Step 2按任务归因对瓶颈单元排序,并选择top-k单元组成任务回路。
既然目标是直接分解权重,一个自然问题是:为何不直接用奇异值分解(SVD)?SVD同样可将矩阵表示为rank-one成分之和,且不需训练数据。近期的NaNA等方法已证明SVD成分可用于任务排序和干预。但对回路分析而言,单元数量少并不等于真正的计算路径少。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。