

DeepSeek上线多模态API,视觉Agent能力接近Opus-4.8
深度求索于8月21日推出多模态视觉理解模型 DeepSeek-V4-Flash-Vision-Exp,并已上线其 API 平台。该模型支持在文本之外输入图片,可完成图片描述、截图文字识别、图表分析等任务,兼容 JPEG、PNG、GIF、WebP 格式。
官方称,该模型在各类 Agent 框架中展现出良好的多模态适配能力,有助于用户借助多样化工具解锁更多实用场景。作为实验性质模型,用户可通过设置 model='deepseek-v4-flash-vision-exp' 进行访问。
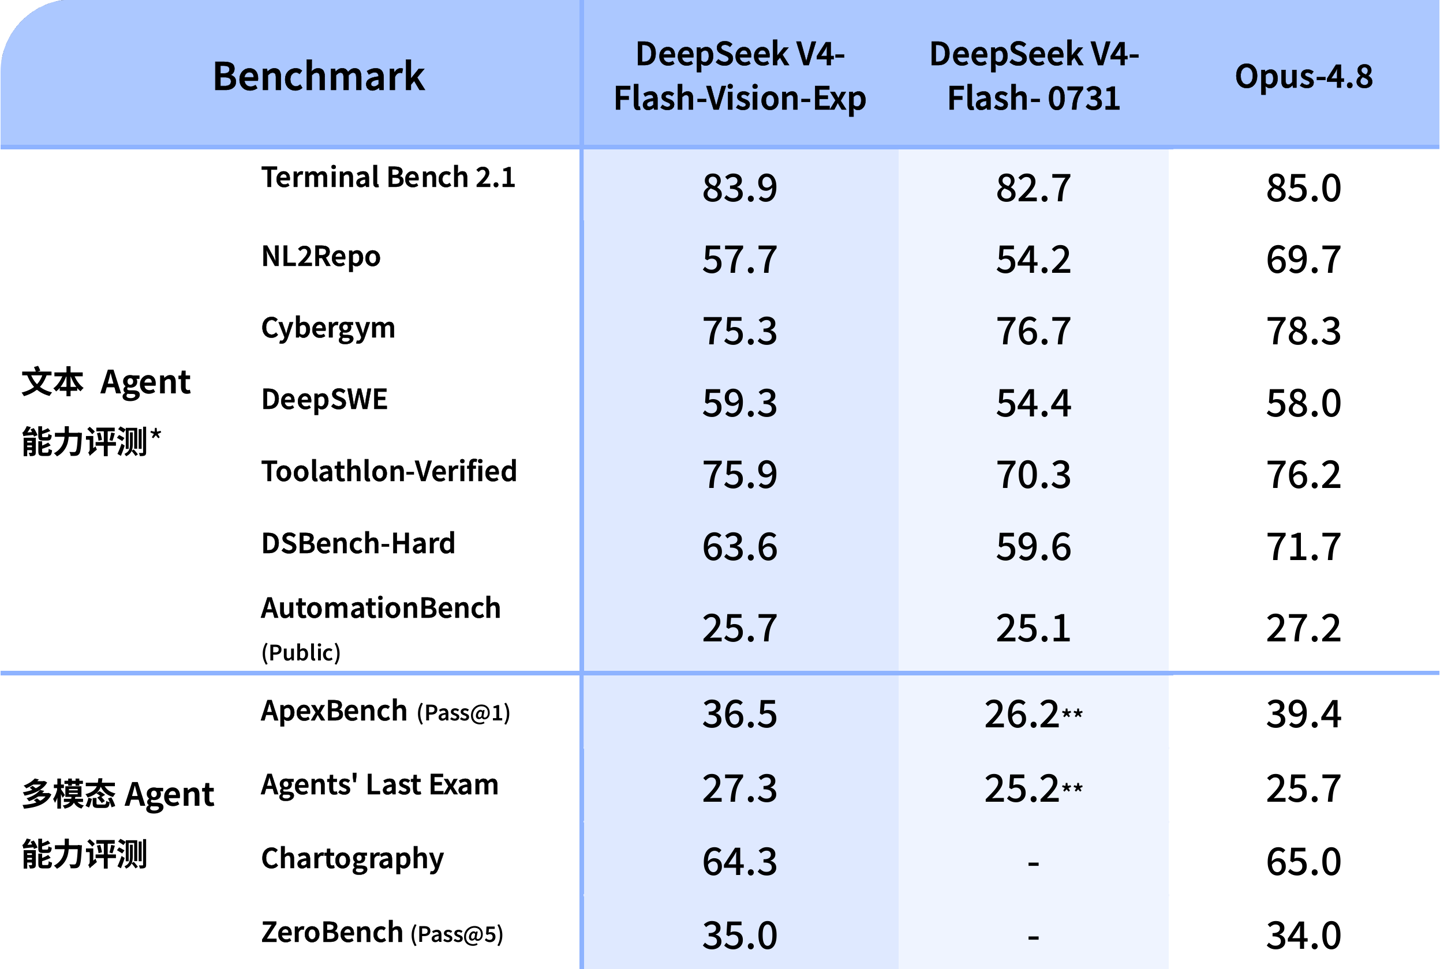
在纯文本能力(如 Agent、推理、世界知识)方面,该模型与 DeepSeek-V4-Flash 正式版持平;而在需要视觉理解的 Agent Benchmark 上,其表现大幅跃升,多模态 Agent 能力已接近 Opus-4.8。
API 服务中,图片会转换为 token 后计费,单张图片最多占用 384 tokens,价格与 V4-Flash 模型一致。多模态 API 支持 Chat Completions、Messages、Responses 三种调用方式,可接入各类 Agent 工具,支持图文混合输入,并提供 base64 内联、外部 URL、Files API 三种图片传入方式。
Files API 现已开放且免费,用户可先上传图片至平台,再在请求中通过 file_id 引用,从而节省请求带宽(同一图片在多个请求中无需重复上传)。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。