

蚂蚁OmniTable获VLDB 2026工业最佳论文,35PB语料处理效率提升5.6倍
蚂蚁集团研发的统一宽表系统 OmniTable 在 VLDB 2026 工业赛道获最佳论文奖。该系统旨在解决大模型训练数据准备中的工程难题,相关论文于 9 月 1 日在波士顿举行的大会上获颁奖项。
大模型训练前,语料需经过解析、清洗、去重、质量评分、Token 化和样本组装等环节。当数据规模达到 PB 级,工程团队面临数百张表、持续增加的特征以及异常数据导致整批任务重跑等问题。OmniTable 通过逻辑统一、物理分离的设计,将同一数据域呈现为一张逻辑宽表,底层按数据规模、访问方式和计算引擎拆分,并将特征作为系统资产进行管理。
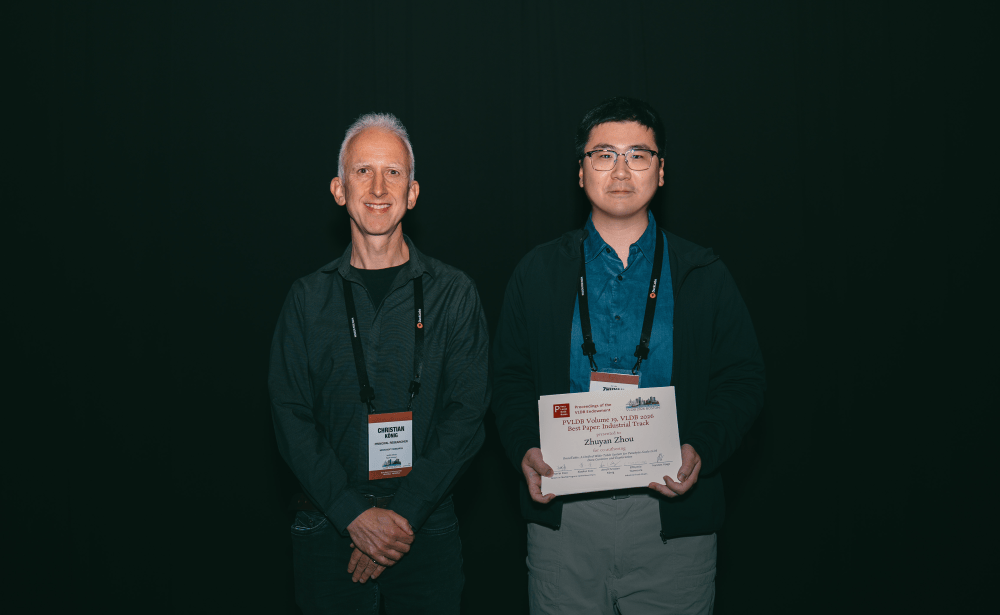
(图说:蚂蚁集团论文《OmniTable: A Unified Wide-Table System for Petabyte-Scale LLM Data Curation and Exploration》获评 VLDB 2026 工业赛道最佳论文,9 月 1 日在波士顿举行的大会上获颁奖项。)
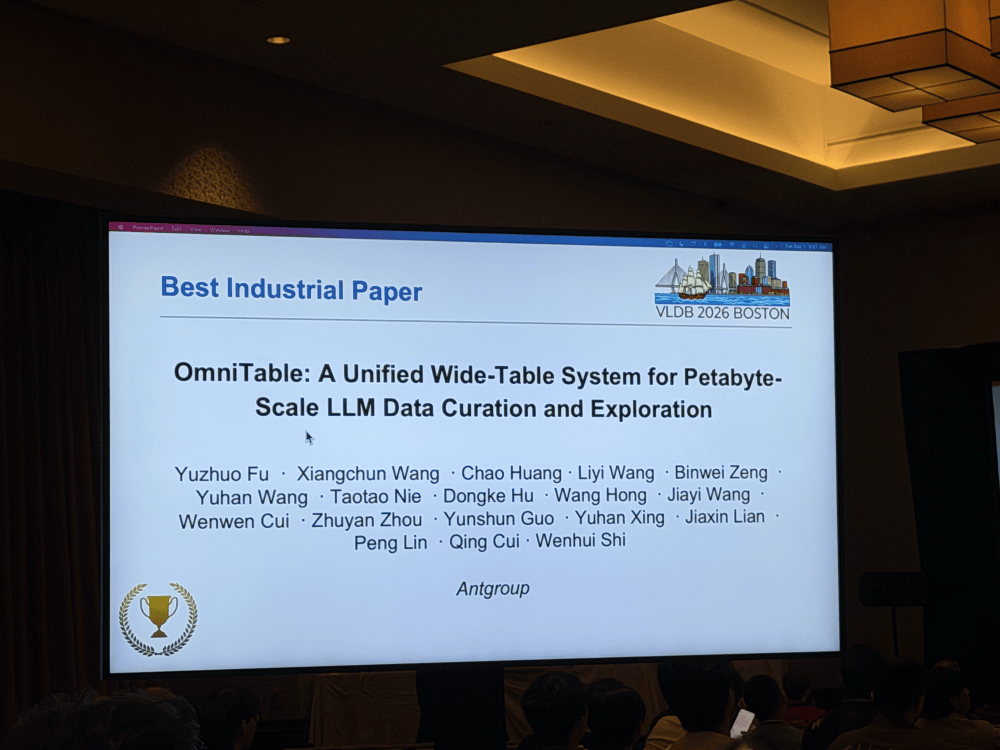
论文链接:https://www.vldb.org/pvldb/vol19/p4276-fu.pdf
据论文披露,OmniTable 已在生产环境管理超过 35 PB、3050 亿条以上的大模型训练数据,覆盖 Web、代码、PDF 和 SFT 等数据域。在一项真实 SFT 数据准备任务中,端到端周期从约 14 天缩短至 2.5 天,手工操作步骤从 45 步降至 12 步。
传统数据加工围绕物理表展开,数据源和特征增加后,维护对象迅速膨胀。例如,为补充一个特征,工程师需处理 106 张表。OmniTable 将问题归纳为数据难定位、特征难回刷、结果难追溯,其核心是让数据批次和特征列成为一等对象,物理表退化为存储实现层。
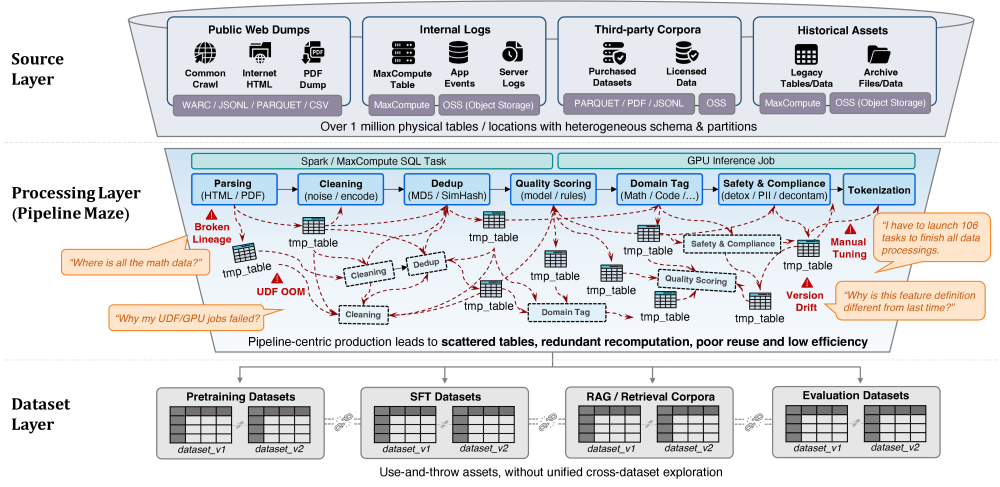
图 1:异构数据经过分散管道后形成彼此割裂的数据集。来源:论文 Figure 1。
在逻辑层,每行代表一条可追踪的数据实体,每列保存处理状态或衍生特征。系统字段 ai_unique_id 作为全局主键,ai_append_name 记录接入批次、来源和版本。生产环境按数据域划分为四张逻辑宽表,合计管理 35+ PB、3050 亿条以上记录,其中最大的 Web 宽表管理约 25 PB、3000 亿条以上记录,包含 800 多个逻辑列和 200 多个已注册特征。受控实验中,逻辑列可扩展至 2500 列。
逻辑列与物理位置的对应由 Catalog 保存,底层可拆行、拆列、合并小文件或建立物化视图,上层 schema 保持不变。为热点列组建立物化结果可能增加约 8%–15% 的存储开销。
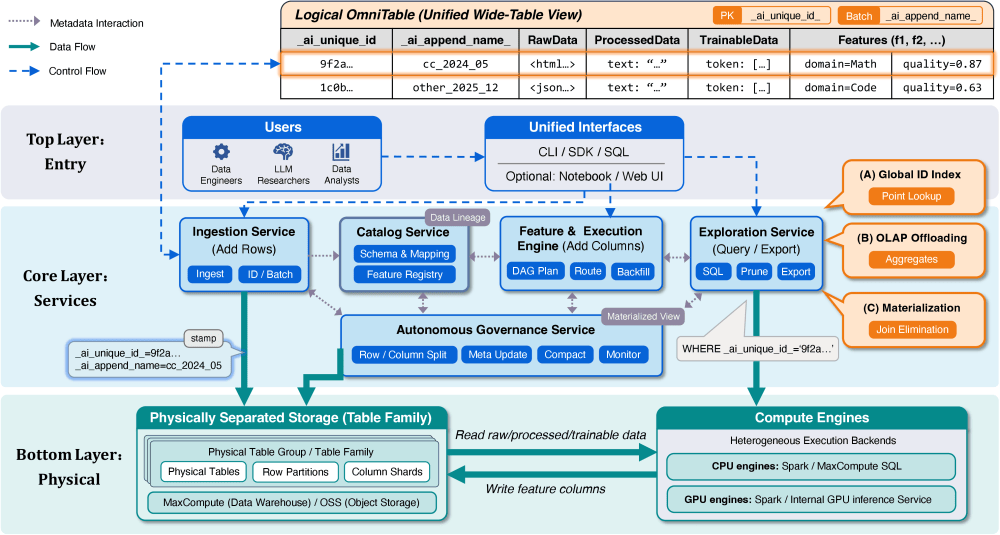
图 2:Catalog 连接数据接入、特征执行、查询导出与后台治理。来源:论文 Figure 2。
特征注册时需明确输入列、输出列、UDF/SQL/模型推理逻辑、版本及执行偏好。工程师提交回刷任务时,OmniTable 会沿列级依赖 DAG 找到最小依赖闭包,并生成物理执行计划。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。