

谷歌Gemini视频理解上线,成本降66%准确率提升7%
谷歌今天发布了 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 模型的智能体视频理解功能。这个功能的目标是提高视频分析的准确率,同时把 Token 消耗和处理成本压下来。
功能走标准 Gemini API Token 定价,不额外收费。传统静态处理方式下,模型按固定帧率读视频,默认 1 FPS,可以通过 API 调。智能体视频理解把模型核心推理和原生视频工具绑在一起,能在视觉帧、音频和转录文本里动态搜索、扫描、检查目标视频片段。
在标准视频分析基准测试里,搭载这个功能的 Gemini 模型能把分析成本最多降 66%,Token 消耗最多降 88%,准确率最多提升 7%。长视频场景里这种效率提升更明显,传统静态处理经常逼着开发者在高 Token 成本和丢失关键细节之间做取舍。
谷歌的说法是,Gemini 3.7 Flash 搭配智能体视频理解,整体质量最好,在质量和成本效率之间找到了平衡点,视频理解任务里处在准确率和成本的帕累托最优前沿。
静态处理是模型按固定帧率读媒体流,智能体视频理解则让 Gemini 主动决定看什么、以什么速度看、用哪种模态(帧、音频或转录文本)拿信息,只提取需要的片段和信号。以前这些要开发者手动做,现在 Gemini 通过智能循环调用内部工具加载视频相关部分,开发工作量少了不少。
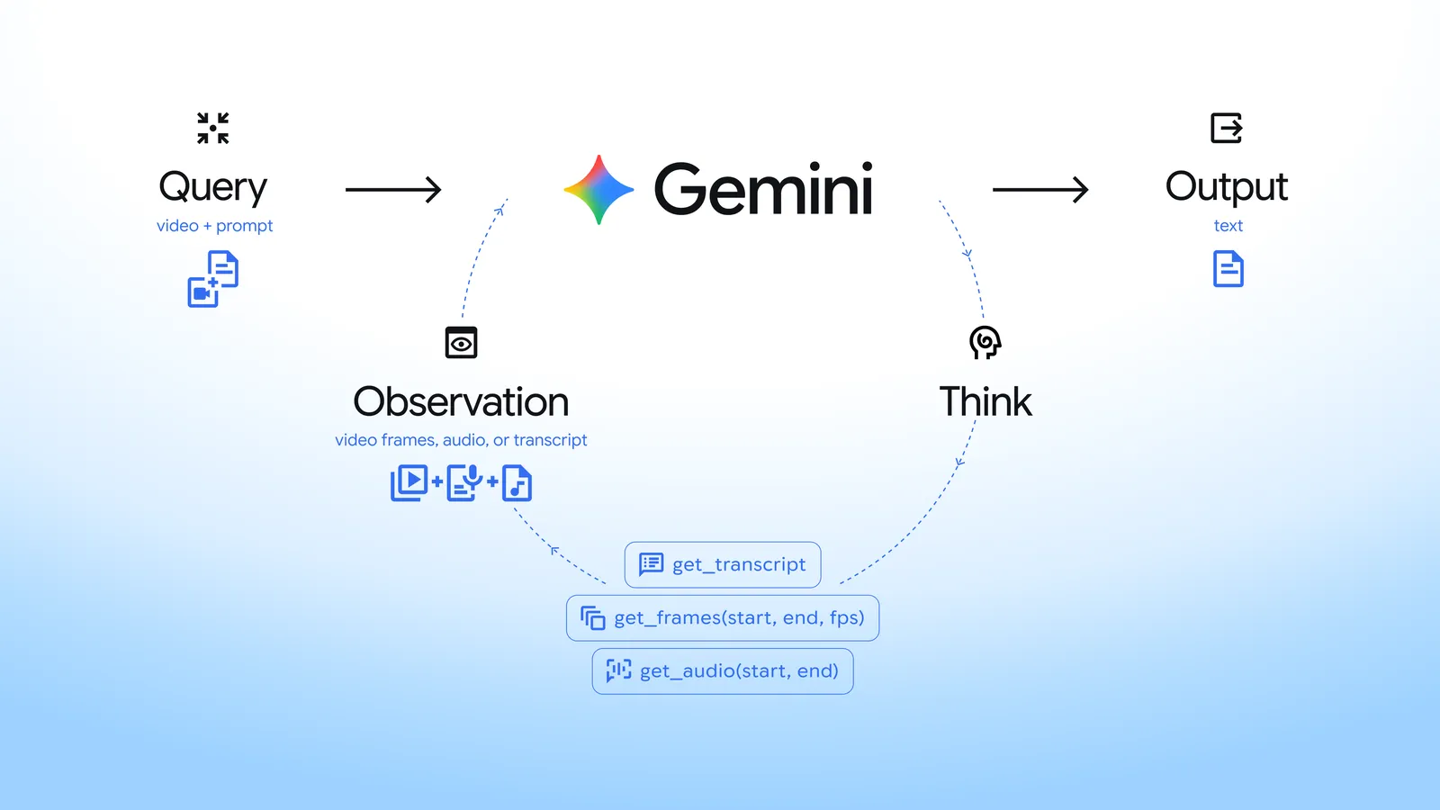
这个功能给开发者处理长视频带来几项新能力:
- 亚秒级时刻检索:能定位 1 FPS 下容易错过的瞬间状态变化和紧凑剪辑边界,做高精度自动化视频编辑。
- 长视频“大海捞针”搜索:在几小时长的视频里回答复杂查询,不用烧几百万 Token。
- 异常检测:对感兴趣的时间窗口用更高帧率重新采样,检查快速运动和细微视觉伪影。
- 动作与物体计数:随时间推移跟踪重复物理动作和不同物体。
功能已经在 Google AI Studio 和 Gemini Enterprise Agent Platform 的 Gemini API 里上线,支持视频上传和 YouTube 视频分析。开发者在 API 配置里把处理模式设成“agentic”就能用。
谷歌还打算把这项能力推广到更多普通用户产品里。功能很快会推送给 Gemini 应用中所有 Flash 和 Flash-Lite 模型用户;未来几个月,智能体视频理解还会给 YouTube 视频观看页的“Ask YouTube”功能提供支持,用 Gemini 给出基于视频画面的回答。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。