

李飞飞团队发布全球首个多模态世界模型Atlas
一张图补全3D世界,还能为机器人构建训练环境。
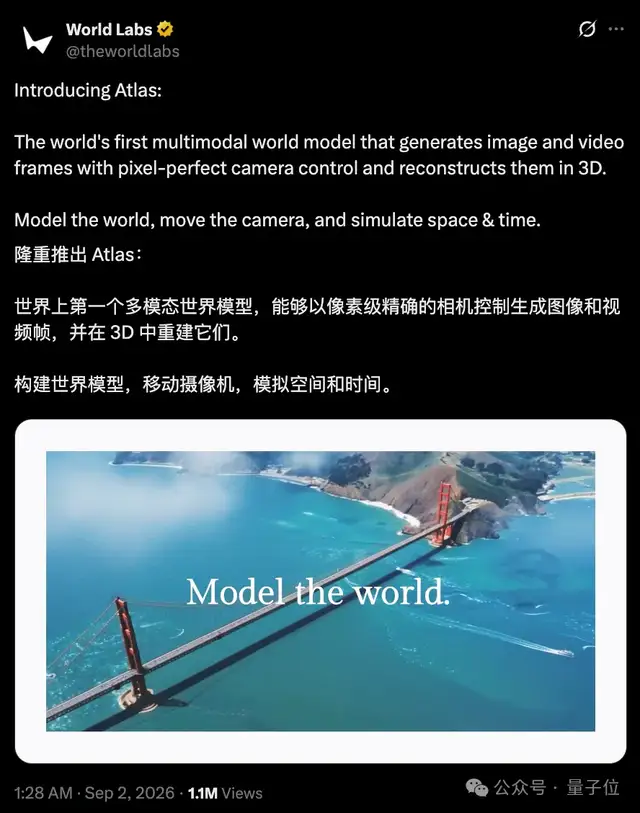
World Labs对其新一代世界模型Atlas的描述颇为自信,除冠以“全球首个”外,其口号也强调,此次不只是生成可互动视频,而是能够以像素级相机控制生成图像和视频帧,并完成3D重建,同时理解空间与时间。
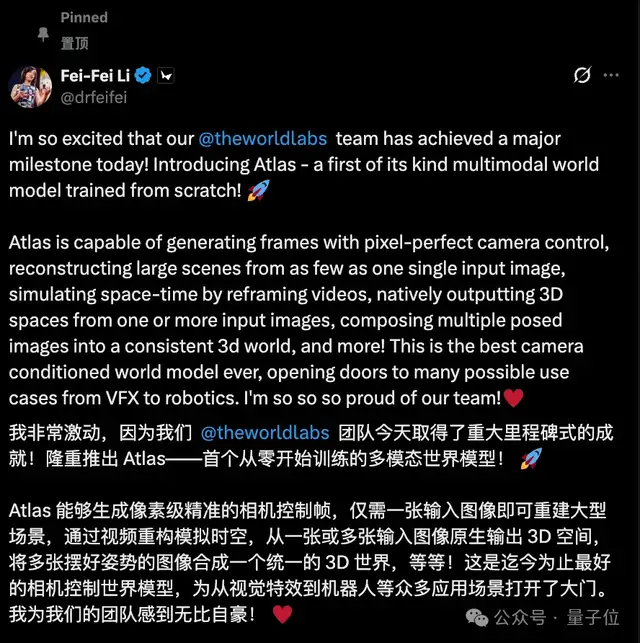
李飞飞将Atlas视为World Labs的“里程碑式”成果,并在社交平台置顶,称其为从视觉特效到机器人等众多应用场景打开了大门。
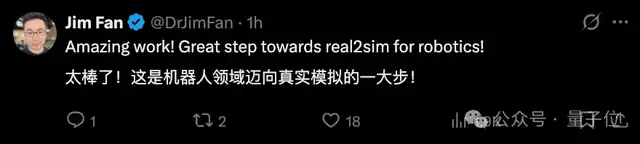
英伟达机器人主管Jim Fan也对此表示赞赏,指出这是机器人领域Real-to-Sim的一大步。
具体而言,Atlas是一个多模态自回归扩散Transformer,其能力包括:
- 相机控制生成:仅需一张图片,即可生成具有像素级相机控制的图像和视频,最高输出1分钟、1440p视频。

-
空间重建:基于一张到数十张输入图像,重建真实世界场景,可生成新视角图像帧或显式3D表示,效果超越当前专门针对3D重建训练的最先进模型。
-
时空模拟:根据输入视频同时建模空间和时间,可转换视频视角,制作戏剧性视觉效果,并支持机器人Real-to-Sim工作流。
-
图像生成:根据文本生成图片和360°全景图,能遵循复杂Prompt、准确渲染文字,并生成多种视觉风格。
在机器人模拟方面,仅需几张照片,Atlas即可生成逼真的RGB和深度数据,使机器人能在更多不同模拟空间中进行训练和测试。
技术细节上,Atlas是一个全能模型(omni model),旨在统一架构中处理多任务、多种输入和输出数据。
为实现这些目标,李飞飞团队设计了新型基础架构——多模态自回归扩散Transformer。文本、图像、视频、3D数据等输入均被锚定在三维空间中,形成空间上下文,Atlas据此生成多模态输出。
例如,将两张无关参考图片放入同一上下文,并指定其在3D空间中的位置,Atlas即可将其融合为一个空间自然、连续的世界。
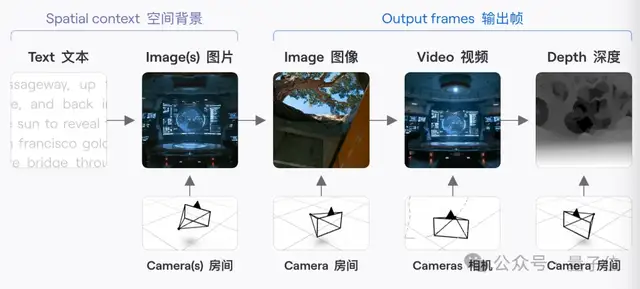
更具体地,多模态指Atlas可原生处理文本、图像、相机位姿、3D深度图等多种数据类型。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。