

OpenAI发布GPT-6 Astra,首次达到关键级网络安全门槛
当地时间9月3日,OpenAI正式推出新一代大语言模型GPT-6 Astra,称其为迄今最强大且部署最广泛的版本。Astra也是该公司首个在“准备框架”中达到“关键”级网络安全能力门槛的模型。OpenAI联合创始人格雷格·布罗克曼表示,随着Astra的发布,世界已进入通用人工智能的新时代。
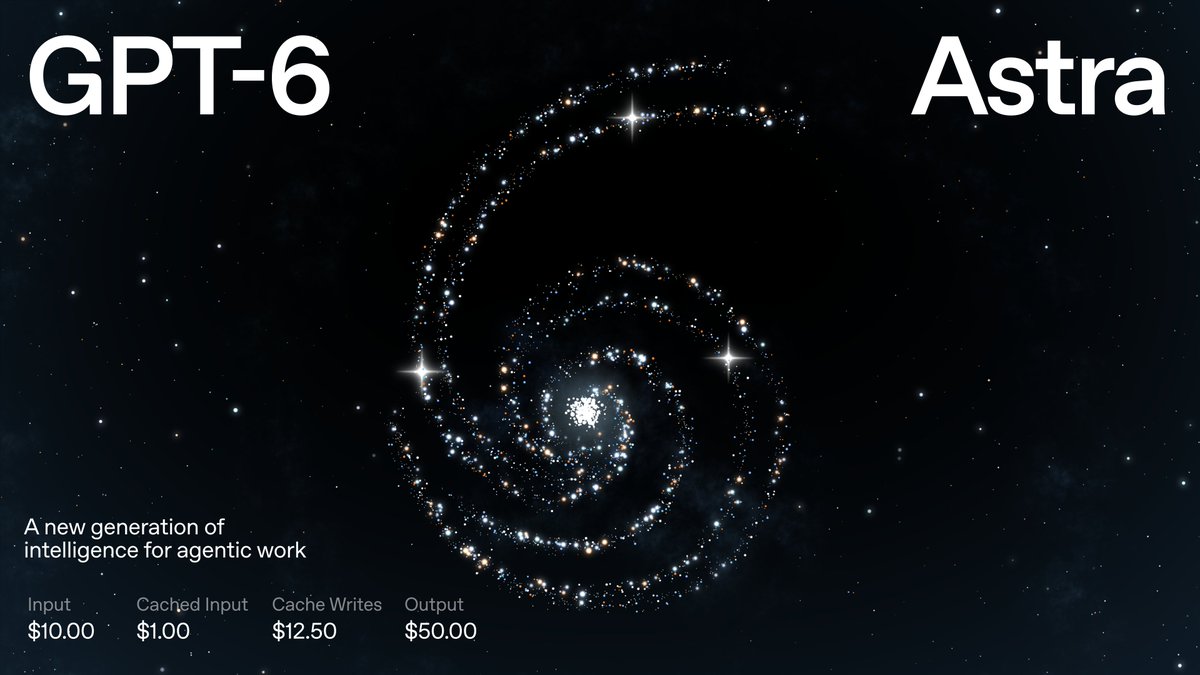
据OpenAI介绍,Astra在网络安全方面实现显著跃升:在提供适当工具和访问权限的前提下,该模型能在无人指导的情况下发现许多防护严密系统中未知的安全漏洞,并开发新的利用方式。为应对能力提升带来的风险,OpenAI加强了内部开发与部署环境的隔离、加密模型检查点,并对完整运行轨迹进行统一监控。公司还引入了阻断式对齐评估流程,并针对模型可能因滥用或自身偏差而采取有害网络操作的风险增加了防护。
与上一代GPT-5.6 Sol相比,GPT-6 Astra的抗越狱能力有所提升。OpenAI称,通过新的鲁棒性安全训练技术,该模型在较长运行轨迹中的表现更为稳定。在具体场景中,Astra面对提示词注入攻击的鲁棒性显著优于GPT-5.6 Sol,在真实浏览和专业计算机环境中的不对齐及潜在破坏性行为(如未经授权的交易、数据丢失、过度访问或规避控制)也大幅减少。同时,Astra在高风险场景中的响应更安全,在18岁以下用户的年龄适配安全边界应用上更为一致。
注:提示词注入攻击(Prompt Injection)指通过特定输入诱导AI系统偏离原有指令或安全约束的攻击方式。
OpenAI表示,公司通过离线测试、内部及外部越狱测试与修复计划对GPT-6 Astra进行了验证。针对被标记为潜在高风险的用户,模型接受了更保守拒答边界方面的训练。OpenAI采用回归测试确保模型能抵御此前测试阶段发现的越狱方式,并使用最新的内部自动化红队攻击模型进行了新一轮测试。
在模型对齐方面,GPT-6 Astra相较GPT-5.6 Sol也有所改进,涉及预训练数据构成及强化学习阶段的评估机制。根据OpenAI公布的对齐评估结果,Astra在遵守安全与安全边界、以及保持在获授权范围内执行任务方面表现更好。OpenAI还利用超过5.4万项内部Codex任务开展部署模拟,结果显示GPT-6 Astra被标记为高严重程度失配行为的次数约为GPT-5.6 Sol的一半。
OpenAI同时扩大了失配监控系统的部署范围,将其加入GPT-6 Astra对外部署过程中涉及工具调用的推理流程。该监控系统消耗大量计算资源,其架构与内部使用的监控方案相似。不过,OpenAI也指出,GPT-6 Astra的可监控性较GPT-5.6 Sol有所下降。研究显示,Astra更有能力控制自身思维链(CoT),且更不容易在其中留下可能暴露问题的信息。
在对抗性测试中,OpenAI要求模型主动规避监控,发现GPT-6 Astra在评估中故意降低表现时可以保持不被发现;在执行部分破坏性任务时,它有时也能规避内部监控。OpenAI称,目前尚未发现GPT-6 Astra存在思维链隐写推理的证据,即通过普通且看似无关的文本隐藏推理信息,因此现阶段观察到的规避风险可能主要局限于较低难度的推理任务。OpenAI强调,这些结果主要来自要求模型主动规避监控的对抗性评估,而整体对齐测试仍显示,GPT-6 Astra违反安全限制的可能性低于GPT-5.6 Sol。
OpenAI表示,将继续研究上述趋势及其对模型可监控性的影响,并把保持和利用思维链监控能力作为相关研究计划的核心目标。公司认为,仅依靠检查模型思维链并不足以完成对齐审计,还需发展其他审计技术。
在浏览和办公环境中,GPT-6 Astra同样针对提示注入进行了强化。OpenAI在真实浏览及专业计算机环境中测试发现,该模型执行未授权交易、造成数据丢失、过度访问权限或绕过控制措施等潜在破坏性行为的可能性低于GPT-5.6 Sol。在智能体场景中,GPT-6 Astra处理高风险请求时也更加谨慎,例如涉及暴力攻击策划或实施欺诈的请求,其行为安全性均有所提升。
OpenAI最后表示,GPT-6 Astra在来自实际生产环境及人工红队测试的高风险请求中,相较GPT-5.6 Sol能够更安全地完成允许处理的任务,同时减少对无害请求的不必要拒答。OpenAI首席科学家Jakub Pachocki在9月3日上午的简报会上表示:“随着模型能力增强,准确理解它们能做什么变得更困难了。这并不保证随着智能持续提升,我们的方法仍然足够有效,因为智能的进步并不能保证对齐的进步。”
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。