

星尘智能发布SmoothRL框架,让在线强化学习适配异步推理
星尘智能(Astribot)基座模型团队近日推出了一款名为 SmoothRL 的在线强化学习框架,专为异步执行环境设计。在当前的 VLA(视觉-语言-动作)和 World-Action 模型应用中,模型常需一次性生成未来一段时间的动作序列(action chunk)。模型规模增大后,推理耗时随之增加,但机器人无法频繁停顿等待模型计算,在投掷等高速动态任务中,任何停顿都可能造成速度损失和任务失败。实际部署因此更倾向于采用异步推理模式:机器人持续执行当前动作,模型在后台并行计算下一段指令。这种异步机制给在线强化学习带来了挑战,模型生成的动作序列与机器人实际执行的动作之间出现偏差,模型“计划”的动作与机器人“执行”的动作不再完全一致。
SmoothRL 框架的核心,是解决异步推理成为常态后,在线强化学习应如何从真实执行的动作中学习。该框架首次将此类异步在线强化学习应用于真实的高动态投掷任务验证,证明在线学习不仅能用于高精度修正,还能适配需要连续加速、精确释放且不能停顿的动态操作场景。
异步执行引发强化学习“对账”难题
传统在线强化学习通常遵循固定节奏:模型先计算动作,机器人执行,再根据结果更新策略。异步执行打破了这一对应关系。当新的动作序列生成时,机器人可能已执行了部分上一轮指令;而新动作序列尚未完全执行,下一轮推理结果就可能到来并覆盖其后半段。这导致一段动作序列中,部分动作来不及执行,部分真正被执行,还有部分从未发生。若强化学习仍将整段动作用于优化,就可能出现“误记功”或“误背锅”的问题。
SmoothRL 将动作序列按执行状态划分为三个区域,只对机器人真正执行的部分进行强化学习,即仅让梯度穿过执行区域(execution region)。这样,模型的优化目标才能与真实运行过程一致。SmoothRL 在训练过程中直接采用异步推理,使模型计算与机器人执行并行发生,确保训练与部署遵循相同的时间节奏。团队将此原则概括为“在部署中强化学习”(Reinforce in Deployment),从训练开始就面对真实执行动态,而非先在理想同步环境中训练再切换至异步部署。
具体实现上,团队采用针对各任务微调后的 π0.5 作为基础策略,沿用 RLT 框架,使用轻量级 TD3 风格的 actor-critic 模型在原始动作空间预测残差修正。S1 机器人以 30 Hz 频率执行动作,推理请求频率为 5 Hz,每 200 毫秒生成一个新的动作序列。基础策略每次预测 32 帧动作;在固定延迟预算下,已提交(Committed)与执行(Execution)区域共占 12 帧,其中 6 帧属于本轮真正执行的区域,其余 20 帧在执行前会被后续序列覆盖。
从高速投掷到毫米级插入,验证两类真实部署难题
团队在绳驱机器人星尘智能 S1 上进行了三项真机测试,覆盖高速动态操作与高精度双臂操作两类互补场景。
-
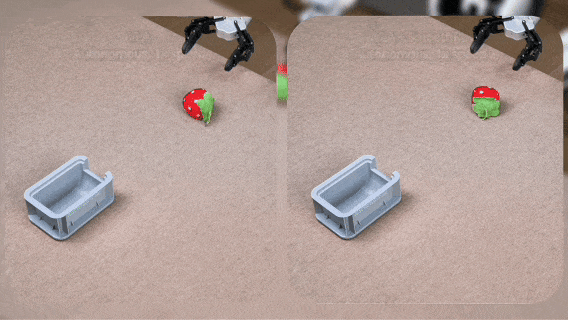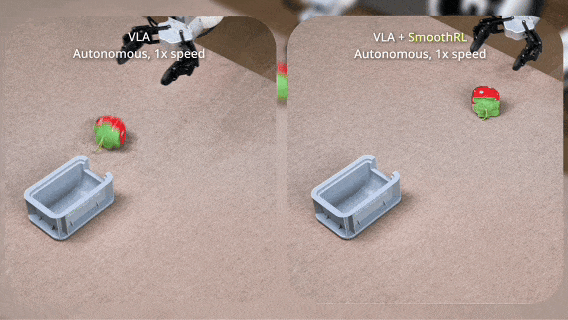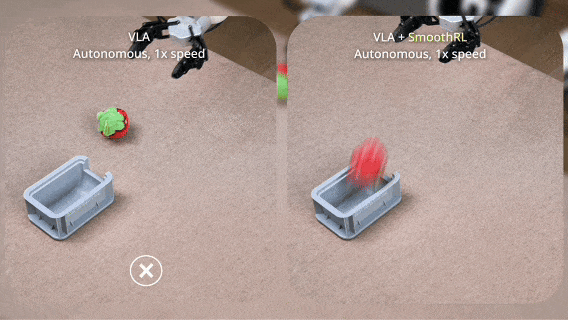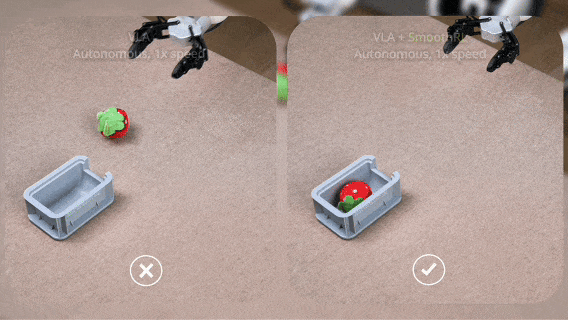
动态投掷:成功率从 39% 提升至 94%。任务要求机器人从随机位置抓取物体并投入不同位置的目标箱,需在摆动过程中持续积累速度并在准确时刻释放。论文指出,若在动作序列边界发生停顿,手臂可能几乎静止,难以恢复所需释放速度,该任务对异步执行尤为敏感。在累计 250 个评估回合后,成功率显著提升。
-
高精度双臂操作:此类任务同样需要异步推理,机器人动作变化快,若每步都等待模型计算则会产生卡顿。SmoothRL 框架在此类任务中也验证了其有效性。
图注:SmoothRL 整体框架:机器人在异步执行中持续产生真实数据,基础策略提供通用能力,在线 RL 会根据真实执行结果更新动作策略。
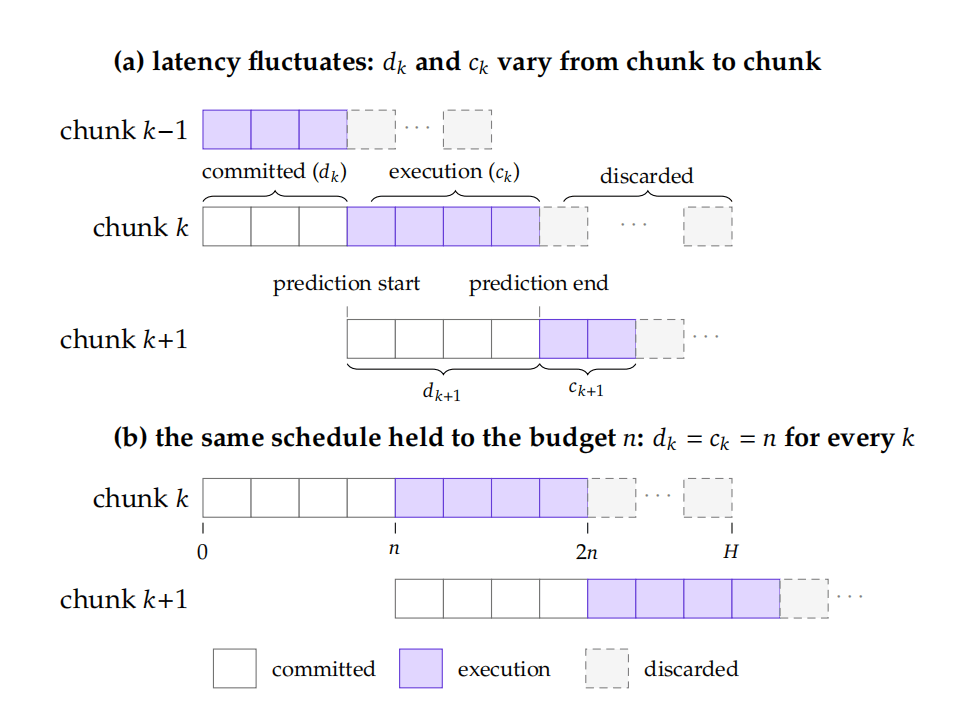
图注:SmoothRL 将异步 action chunk 划分为 Committed / Execution / Discarded 三个区域,并只让价值梯度通过真正执行的 Execution Region。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。