

小米开源表格数据大模型TabLDM,回归能力登顶OpenML-CTR23
小米于9月5日正式发布通用表格数据基础大模型Xiaomi-TabLDM。该模型采用单一预训练模型和统一默认配置,可直接适配不同表格数据集,无需针对每个任务重新训练、调参或后置集成,即可完成分类与回归预测。
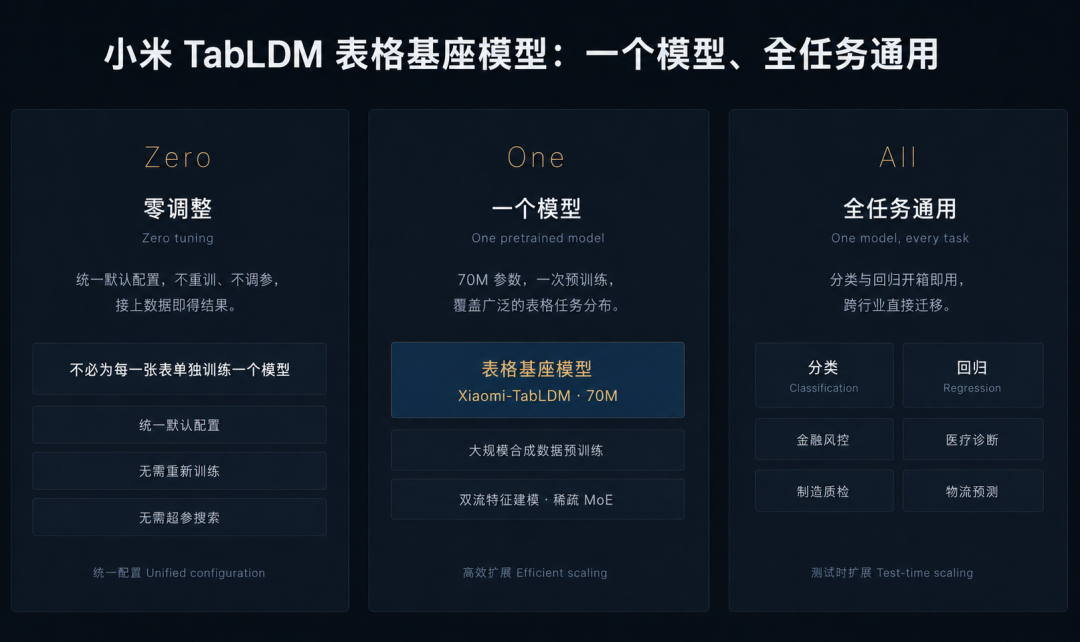
金融、医疗、制造、物流等领域大量核心数据以表格形式存在,但传统表格机器学习通常需针对每个新数据集重新训练、调参甚至集成模型,部署代价高。Xiaomi-TabLDM旨在将“一次预训练、跨任务使用”的基础模型范式引入结构化数据领域。
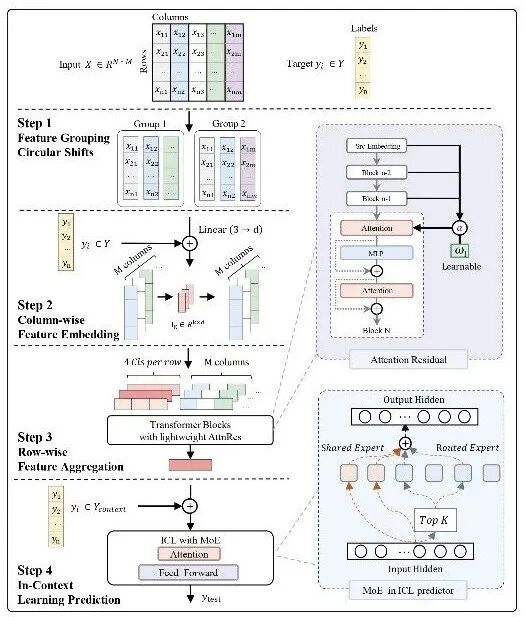
该模型从三方面推进表格基础模型能力:
- 预训练:完全基于结构因果模型(SCM)生成的大规模合成数据,覆盖不同数据规模、变量类型、依赖关系和函数关系,扩大预训练任务分布。
- 模型架构:引入双流特征分组、轻量级注意力残差和稀疏混合专家,从不同粒度建模特征关系,通过稀疏专家扩大模型容量。
- 推理:探索Test-Time Scaling,在保持预训练模型参数不变的情况下,通过增加推理阶段计算量持续提升预测性能。
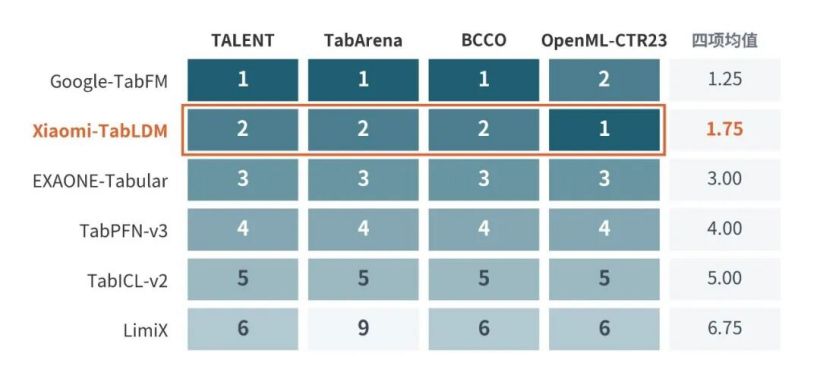
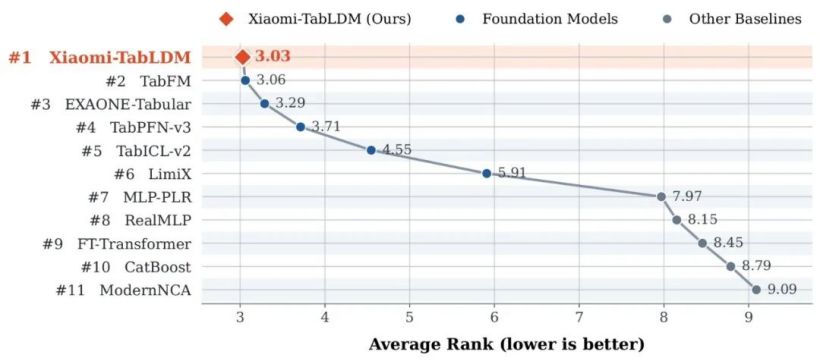
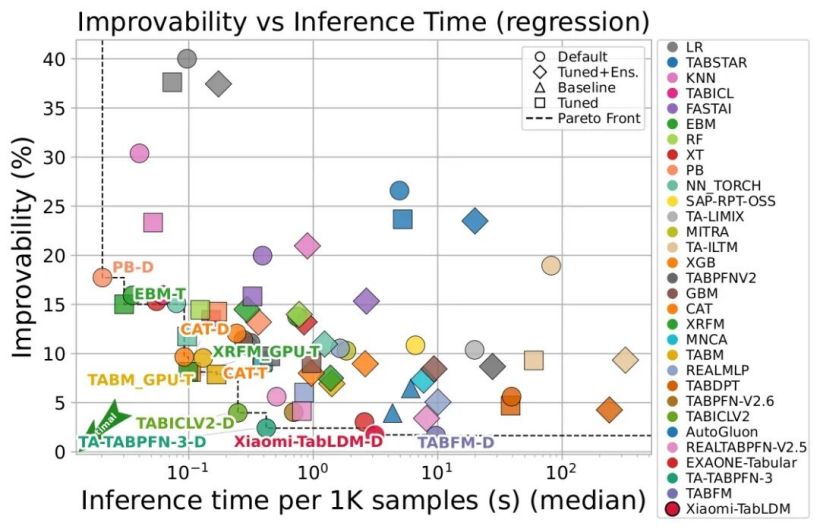
在四大公开基准评测中,Xiaomi-TabLDM均跻身第一梯队。回归能力表现突出:在OpenML-CTR23回归榜排名第一;在TALENT、TabArena和BCCO的回归任务中均排名第二;在TALENT二分类任务中同样排名第一。以TabArena回归任务为例,Xiaomi-TabLDM取得第二高Elo评分,训练时间比排名第一的TabFM减少82%,预测时间减少68%。
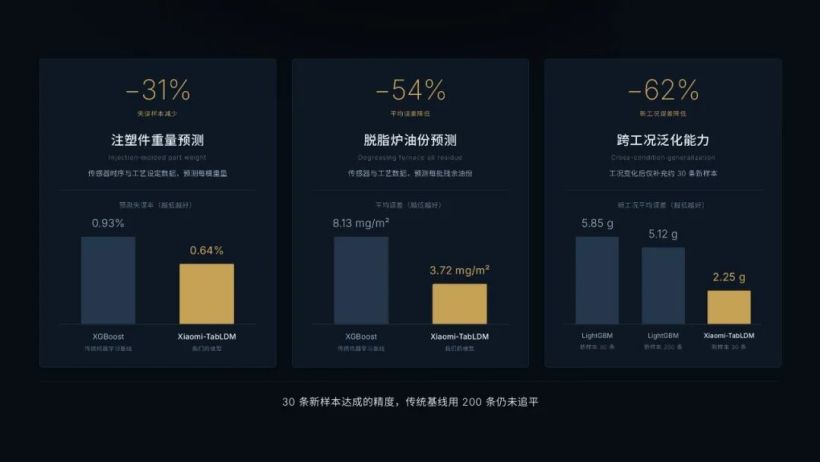
在真实工业场景验证中,Xiaomi-TabLDM相比传统机器学习展现出更高预测精度和跨工况适应能力:
- 材料性能预测:无需微调即可将预测精度提升130%,减少约90%的无效试模与装机测试。
- 零件重量预测:相比XGBoost,失误样本比例降低约31%。
- 生产组分预测:平均误差相比XGBoost降低约54%;当生产工况变化时,仅补充约30条新工况样本作为上下文,即可将平均误差降低约62%。
该模型提供scikit-learn兼容接口,可通过pip安装使用。目前,Xiaomi-TabLDM相关模型权重与代码已正式开源,代码、权重及技术报告可通过以下链接获取:
- 代码:https://github.com/xiaomi-research/xiaomi-tabldm
- 权重:https://huggingface.co/occams/Xiaomi-TabLDM
- 技术报告:https://arxiv.org/abs/2609.03880
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。