

菲尔兹奖得主团队用4B手机模型刷爆ARC-AGI 3
在ARC-AGI 3基准测试中,一个可在手机上运行的4B参数模型与云端753B模型组合,取得了接近满分的成绩。该组合由4B的Qwen-3.5与753B的GLM-5.2构成,其中GLM-5.2在云端运行,手机端仅需运行Qwen-3.5,且大模型全程不输出文字,最终答案由小模型写出。
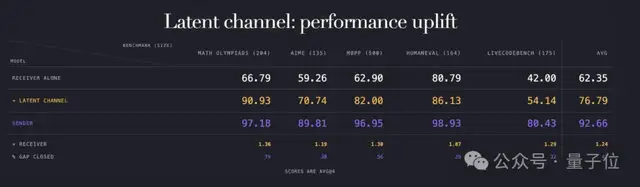
具体技术细节尚未公开,背后团队Mostik拒绝在此刻披露,因为比赛尚未结束。Mostik认为,他们搭建了一座桥梁,使模型间的信息传递效率提升了几个数量级。根据团队披露的实验结果,该方案能让4B模型补上与753B模型约50%的性能差距,自身准确率提高25%;在大小模型差距更明显的难题子集上,提升达到2倍。同时,大模型侧的推理成本被压缩至原本约二十分之一。
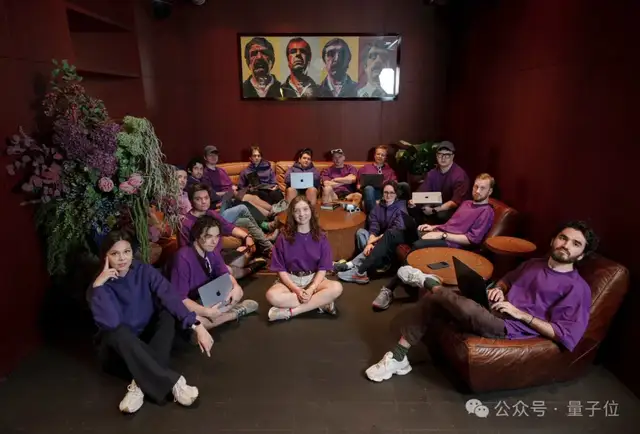
Mostik成立仅4个月,团队共15人,其中12名博士,包括2010年证明统计物理中“渗流模型”和“平面Ising模型”共形不变性的俄罗斯数学家Stanislav Smirnov(斯坦尼斯拉夫·斯米尔诺夫)。
大模型生成一个token的过程中,内部会构建超过一百个隐藏向量,包含约一百万个数值,约两兆字节的内部状态信息。随后,它从约15万词的词表中挑选一个token输出。17个比特离开模型,两兆字节被丢弃,不再使用。目前所有多模型协作系统,包括编程子智能体、模型委员会、路由调度,均建立在这17个比特之上。
近两年的可解释性研究给出了明确答案,这是深层计算的核心内容。一篇ICLR 2026发表的论文显示,Qwen-3在写出“accountant”之前几个token,内部已携带该词的表征,正是这一表征让模型提前选对冠词“an”而非“a”。模型越大,这种提前规划能力越强,内部状态中携带的“未说出口”信息越多。
Anthropic的可解释性团队在Claude 3.5 Haiku上也观察到类似现象:模型写诗时,落笔前已确定韵脚。他们进一步发现一种名为“J-space”的结构——模型在任意时刻维护一组未表达的概念,既非输入回声,也非对下一token的猜测,而是当前正在处理的信息。Anthropic团队总结道,这些测量揭示了从未出现在输出中的内部推理和反应。这意味着,当一个模型为另一个模型写出文字时,丢失的不是格式信息,而是做出选择背后的深层计算过程。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。