

智象发布具身世界模型HiDream-O1-Embodied,登顶RoboColiseum扰动适应榜
智象未来(HiDream.ai)今日正式推出具身世界模型HiDream-O1-Embodied。该模型基于原生全模态技术理念,旨在强化机器人的物理感知与动态预判能力,推动具身智能实现更复杂的物理交互。此次发布标志着智象在打通图像、视频、3D、动作等模态,以及贯通理解、推演、执行全流程方面,逐步构建起统一世界模型基座的技术闭环。
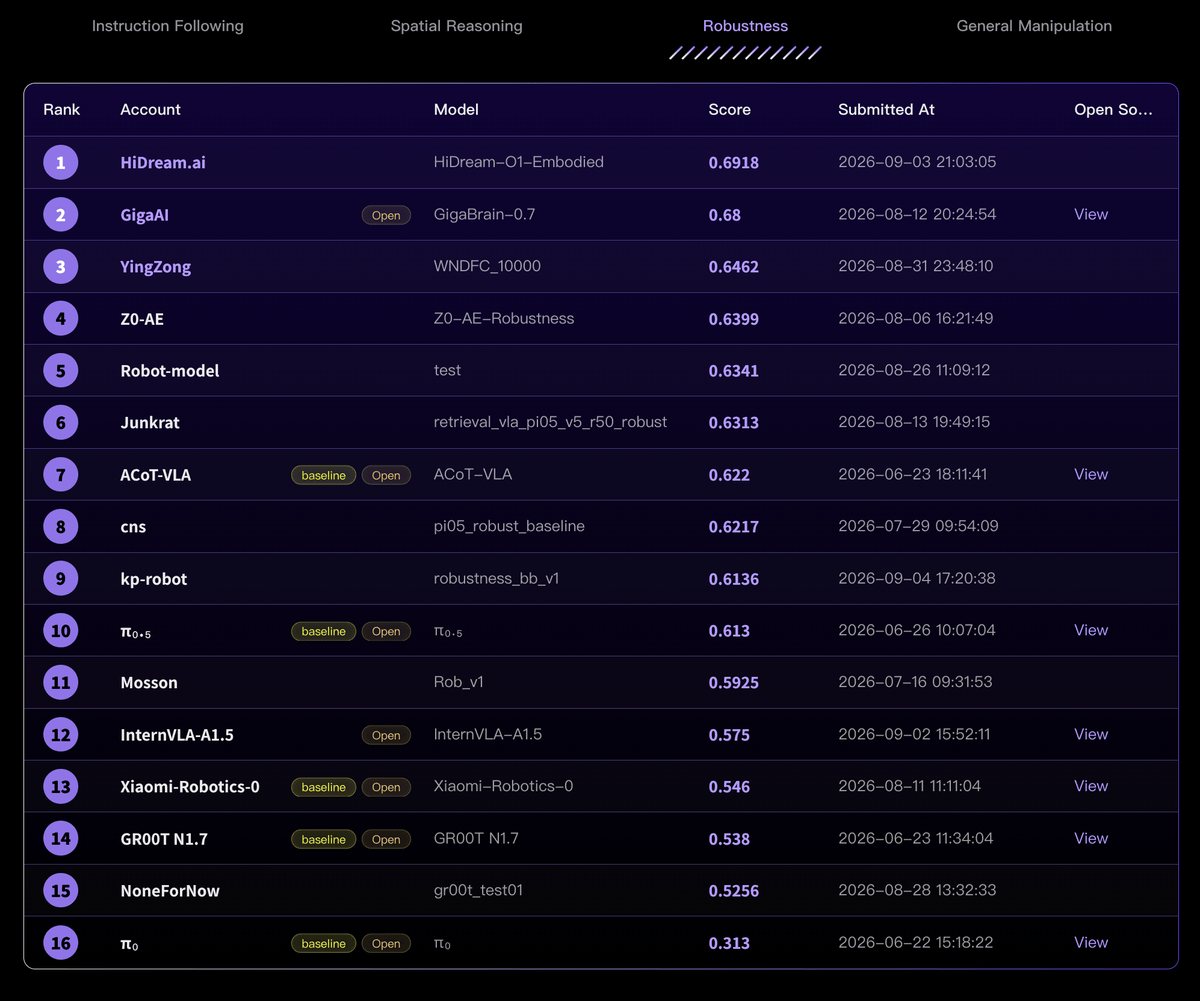
在模型发布的同时,HiDream-O1-Embodied首次参与具身智能模型评测平台RoboColiseum的评测,即在核心的扰动适应(Robustness)子榜单中,以平均分0.692的成绩位列榜首。
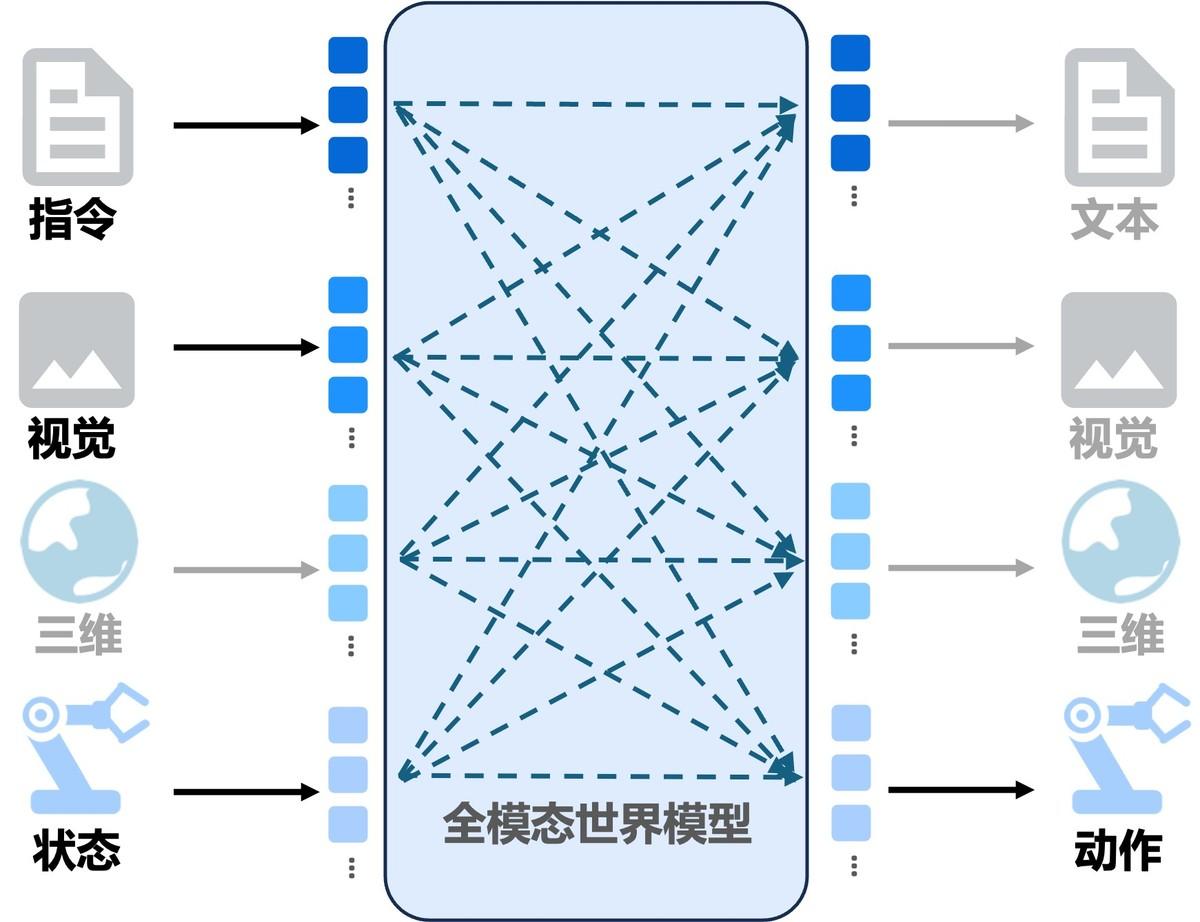
智象未来CTO姚霆表示,构建完整的世界模型基座,需要围绕真实世界的表达、理解和生成,同时具备全模态表达、因果推演与物理世界构建三大核心能力。智象的原生全模态技术理念,从设计之初便计划面向包括动作在内的全模态统一表征。HiDream-O1-Embodied的发布,是该技术战略从“模拟世界”迈向“真实世界”的关键一步。
登顶RoboColiseum:0.692分的“扰动适应”成绩
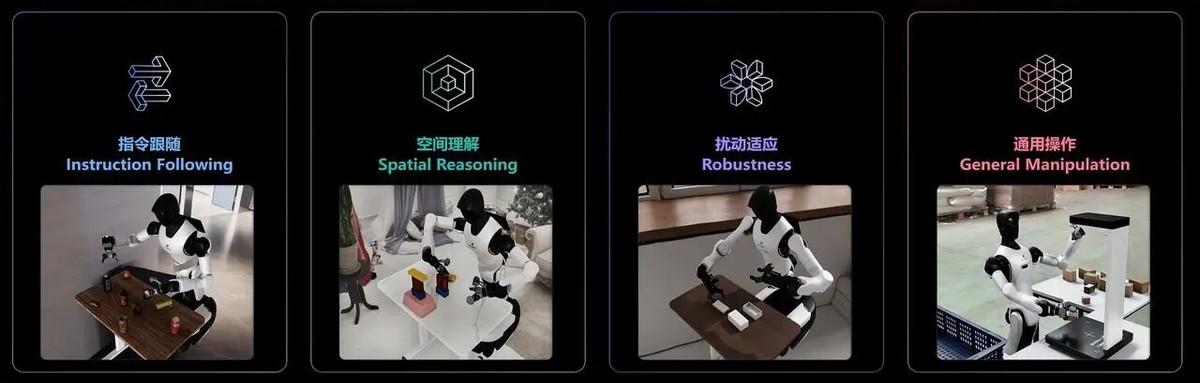
RoboColiseum是一个常态化的具身智能仿真评测平台,旨在通过高保真仿真环境,提供与真机表现高度一致的评测体系,帮助开发者识别模型能力优势与短板。平台面向全球高校、科研机构及企业开放,实时更新结果,并围绕指令跟随、空间理解、扰动适应与通用操作四个维度,设有4类能力子榜和78个评测任务。其中,扰动适应被公认为最具挑战性,它通过改变背景、光照、材质、机器人状态、相机位置与图像质量,并对指令进行多样化改写,检验模型在非理想环境中的稳定性与泛化能力。
HiDream-O1-Embodied以0.692分的成绩登顶该榜单,得益于其原生全模态底座。在执行环节,为应对真实世界的各类干扰,该模型在理解精准度、视觉感知稳健性和抗干扰能力上进行了针对性创新。
- 指令理解:模型覆盖多元动词、句式与表达方式的等价指令空间,能穿透字面变化,锁定用户意图。
- 视觉感知:通过综合多个视角信息,模型让不同视觉通道相互补充,在部分信息偏差或不可用时,仍能借助其他视角理解场景并执行任务。
- 高容错机制:训练阶段主动引入光照变化、画面污损、视野遮挡等非理想条件,使模型学会从有限线索中作出可靠判断,提升在复杂环境中的持续稳定性。
模型与数据双驱动:构建“真实基座+生成增强”范式
模型在训练中接触的数据质量,直接影响其认知边界。智象采用“模型+数据”双驱动策略,探索出“真实基座+生成增强”的数据生产范式。以与诺亦腾的合作为例,其高精度真人动作捕捉数据作为真实底座,智象借助原生全模态能力进行数据精细化扩增,基于单段真实动作样本生成变体视频,在恪守物理约束的前提下,切换背景、光照、物体形态等变量,产出多元训练样本。这一机制使模型既作为“考生”也作为“出题人”,主动生成针对性样本,形成数据与模型互相驱动的增长飞轮。
不到一个月前,智象发布了交互式世界模型HiDream-O1-World,并在交互式视频世界模型评测基准WBench的Navi分榜中以平均分80.9登顶。交互式世界模型侧重“理解与推演”,具身世界模型侧重“操作与执行”,两者互补,为原生全模态世界模型的发展奠定基础。
智象未来创始人兼CEO梅涛博士此前表示,下一代大模型竞争的关键在于从单模态走向多模态,并最终实现原生统一的全模态。从HiDream-O1-Image到HiDream-O1-World,再到HiDream-O1-Embodied,智象正逐步形成覆盖视觉模型、交互式世界模型及具身世界模型的模型家族矩阵。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。