

蚂蚁百灵发布金融增强模型Ling-3.0-flash-Fin,瞄准真实投研工作流
外滩大会前夕,蚂蚁集团百灵正式发布首个金融增强开放模型 Ling-3.0-flash-Fin。与以往侧重问答、摘要等单点任务的金融大模型不同,该模型瞄准真实金融工作流,尝试推动AI从“回答问题”向“完成工作”转变。目前,模型已正式开源。
同步开放的还有金融搜索Agent评测基准FinFIRST,蚂蚁百灵逐步构建模型、工具与评测体系。模型现阶段聚焦投资研究场景,覆盖信息检索、研究推理、估值建模、研报撰写等环节,旨在打通从资料查找到成果生成的完整任务链。
金融被认为是检验模型专业能力的重要领域。业内分析指出,Ling-3.0-flash-Fin的推出,是蚂蚁百灵从通用能力向专业场景探索的关键一步。蚂蚁集团在金融场景积累深厚,百灵可依托复杂真实场景验证模型能力,并持续迭代优化。
金融AI竞争:从“会回答”到“能干活”
金融长期被视为AI迈向专业生产力的高难度场景。一份研究报告往往需要从年报、财报、公告、监管文件和研究材料中搜集信息,核对不同报告期与统计口径,再进行计算、估值建模,最终产出可供专业人士审核和复用的成果。
金融AI面临的并非简单的“知识问答”,它需明确答案来源、数据可用性、计算准确性以及结论的可复核性。Ling-3.0-flash-Fin正是针对这一完整工作链路设计。
该模型基于Ling-3.0-flash打造,延续124B总参数、5.1B激活参数配置,具备256K长上下文能力,兼顾复杂金融内容处理与部署效率。通过金融语料持续预训练、领域后训练和工具使用优化,模型强化了对年报、财务工作簿、多份研究材料等复杂内容的处理能力。
从定位看,Ling-3.0-flash-Fin更强调长链路Agent工作能力:将信息检索、证据审查、计算、建模和报告准备视为连贯任务,而非孤立步骤,以完成完整的金融研究工作。
目前,该模型率先切入投资研究场景,重点强化四项能力:
- 信息检索:优先定位官方、一手及高可信数据源,关注信息时点和统计口径;
- 研究推理:通过多步计算和交叉验证,厘清事实与假设,构建可复核证据链;
- 估值建模:进入真实工作簿,支持公式切换、跨表依赖和异常排查,使AI输出可融入专业人员原有流程;
- 研报撰写:组织事实、数据和判断,生成可编辑、可审核的研究材料。
这四项能力对应从信息搜集、验证、计算、建模到成果形成的完整投研链路,标志着金融AI竞争正从单点能力转向完整工作流。
不止发布模型,还尝试建立金融AI“评分尺”
与模型同步推出的FinFIRST,旨在解决如何评估金融Agent表现的问题。FinFIRST(Financial Information Retrieval, Sourcing and Traceability)由蚂蚁集团构建并开源,中金公司投行团队提供专业支持,50余位金融专业人士参与设计,重点评测金融搜索Agent在信息检索、信源选择、口径判断和推导过程等方面的能力。
在该评测体系下,优秀的金融AI不仅需给出正确答案,还需回答三个问题:信息从哪里来、口径是什么、结论如何得出。
数据组成方面,FinFIRST覆盖中国内地、美国、中国香港及其他市场,其中中文题占60.2%,英文题占39.8%。超过五分之四的题目包含多个相关子问题,61.8%要求显式计算,32.5%需多个信源,75.6%不直接指定信源,需Agent自主搜索和判断。所有题目均使用公开可访问的信源。
FinFIRST提供了一套贴近真实金融需求的搜索任务、标准与评测方法,并非简单模型排行榜,而是试图将金融研究中的专业判断转化为可验证、可复用的评测标准。
目前,Ling-3.0-flash-Fin已在FinFIRST、FinSearchComp Verified、Finance Agent、APEX-Agents、SpreadsheetBench、τ³-Banking等多个金融智能体基准上测试,覆盖金融信息检索、投资研究、长程任务执行、估值建模和银行业务等场景。评测显示,模型综合表现超过部分大尺寸旗舰模型,在同尺寸模型中具备较强竞争力。
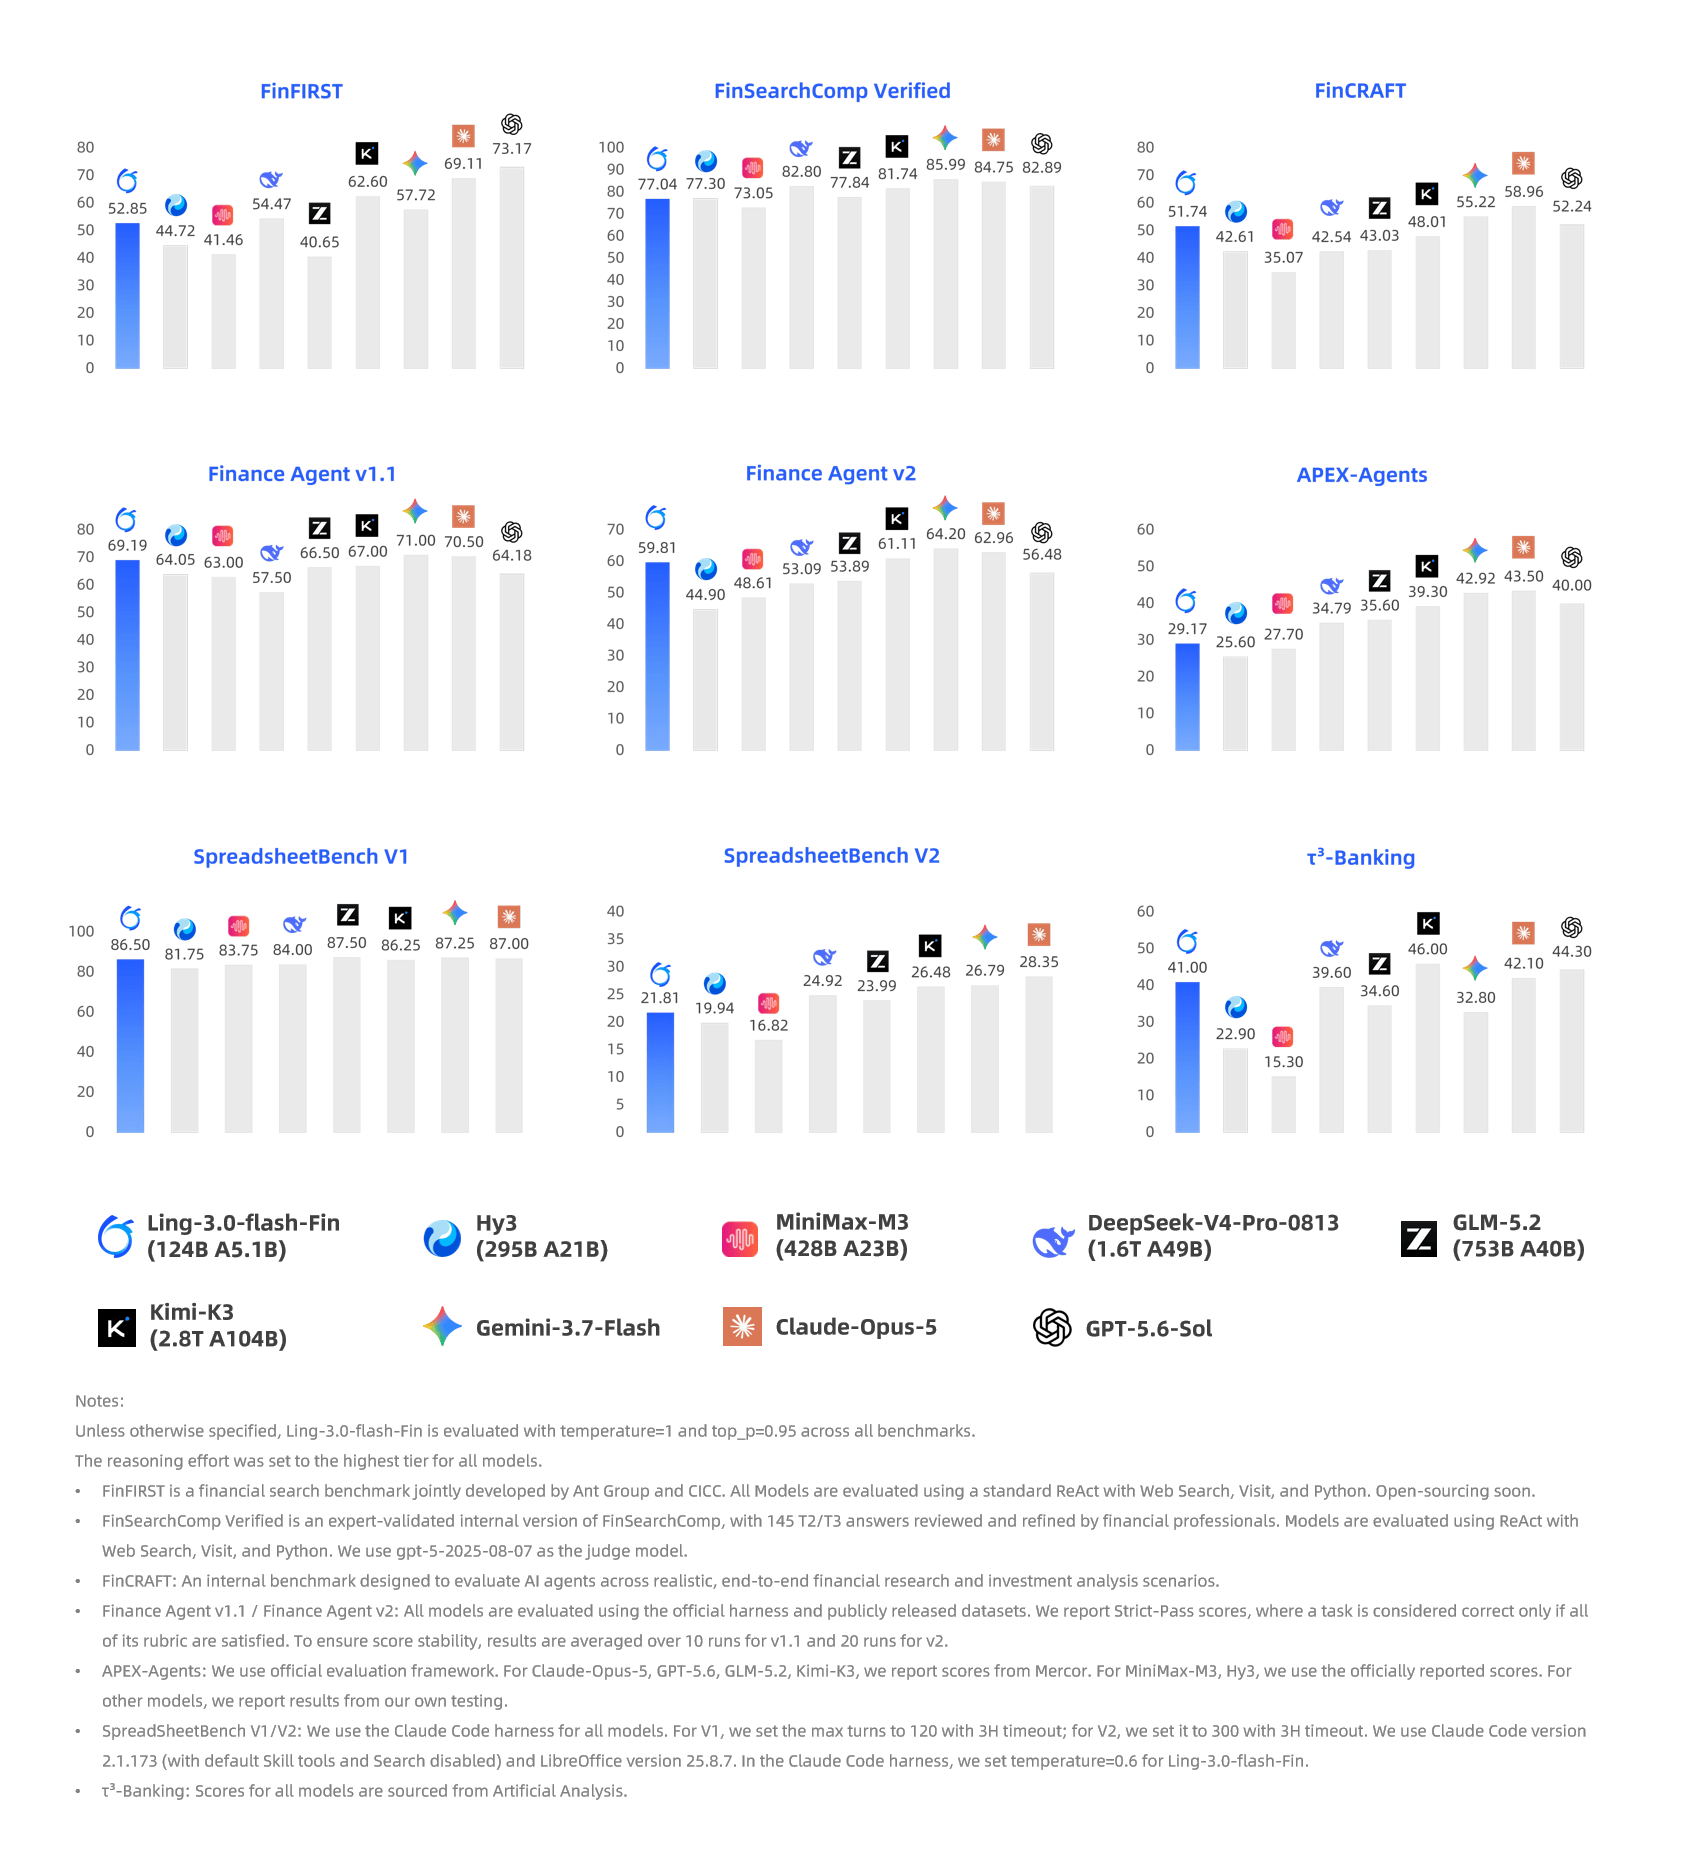
此次Ling-3.0-flash-Fin的另一特点是“模型+工具+评测”同步开放。相比单纯发布行业模型,百灵希望将模型能力置于真实任务中验证,并通过开放评测吸引金融机构、研究团队和开发者共同参与迭代。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。