

生数Motus2让机器人学会自我进化
机器人拧灯泡时如果拧歪了,如何发现问题并改进?这正是机器人"自进化"的意义所在:人类无法示范所有场景,机器人需要能评价动作结果并从反馈中持续学习。生数科技最新发布的Motus2在这一方向进行了探索,同时集成了触觉、灵巧操作、Ego数据等当前具身智能领域的热门能力。
今年2月,前代Motus发布时,世界动作模型概念尚不成熟,而Motus在50项通用任务测试中,较Pi-0.5绝对成功率高出35%以上。在此基础上,Motus2进一步拓展视觉、语言、动作与触觉等模态,在一个模型中同时具备行动、预测、评估三种能力,形成闭环。
Motus2相比上一代最核心的变化是"自进化"。传统机器人策略模型只学习"看到A就做B"的统计关联,不理解B为何能导致期望结果C,环境一变便容易失效。Motus2将行动、预测、评估三种能力放在同一模型中:
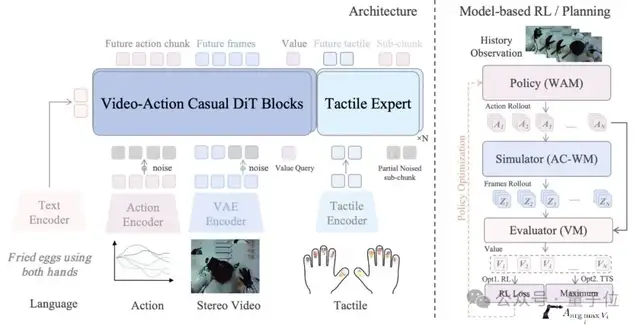
更关键的是,这三种能力不再彼此独立,而是形成闭环:模型自己预测和评估出的结果,成为改进自身策略的反馈;改进后的策略又进入下一轮迭代。这是Motus2对递归自我改进(Recursive Self-Improvement,简称RSI)的一次初步探索。需要说明的是,这里的"自进化"指的是利用模型自身的预测和价值反馈持续改进策略,并不意味着机器人已经能在开放环境里无限自主学习。
要让同一个模型既能"上手干活"又会"预判未来",必须解决一个核心问题:绝不能让它在做动作之前就提前"偷看"到动作执行后的结果。这是时序上的作弊,一旦发生,即便模型在训练集上表现聪明,换到真实场景也会立刻露馅。这也是此前许多"视频生成+动作控制"训练方案失败的原因——模型学会了用未来的视觉帧来"反推"当前动作,而非真正学会决策。
因此,Motus2从机器人领域中间训练阶段开始采用Action-first(动作优先)的信息流,相当于给模型定好了顺序:先根据当前观测生成动作,再预测动作带来的结果,最后评估结果好坏。当模型明确了信息流的先后关系后,接下来是把预测结果真正变成决策和学习信号。Motus2分别从推理阶段和训练阶段入手。推理阶段,Motus2采用了一种叫Best-of-N规划的办法:模型先想好几个候选动作,分别脑补执行后的画面,再由价值模型打分,挑一个分数最高的去执行。执行完一小段,机器人重新观察真实世界,再开启下一轮。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。