

亮源新创连发三项技术,导航模型零样本适配四种机器人本体
过去一年,具身智能技术迭代提速。VLA、世界模型持续演进,强化学习重回机器人学习的重要位置,Sim2Real加速从仿真走向真机,全身控制能力也在快速突破。机器人能走、能跑、能抓、能导航,还能完成日益复杂的长程任务。
但把能力放进真实世界后,一个更基础的问题浮现:机器人“会做”一件事,与在开放环境中长期、稳定、泛化地把事情做成,是两回事。能跨过固定高度障碍,不代表换一种障碍仍能完成;能在一个房间导航,不代表换场景、换本体仍有效;正常状态下能稳定行走,不代表受撞击、跌倒或关节损伤后还能继续工作。随着具身智能从Demo走向真实世界,行业评价标准正在变化。上一阶段关注“会多少技能”,下一阶段更关注能力能否持续规模化扩展。这里的Scaling不只是模型参数量或数据量,而是模型能否经历更多环境、覆盖更多任务、迁移到更多机器人本体,并在进入物理世界后继续适应训练阶段未见过的状态。
过去一个多月,亮源新创连续发布三项技术:LightParkour、LightNav-0和Light REACT。
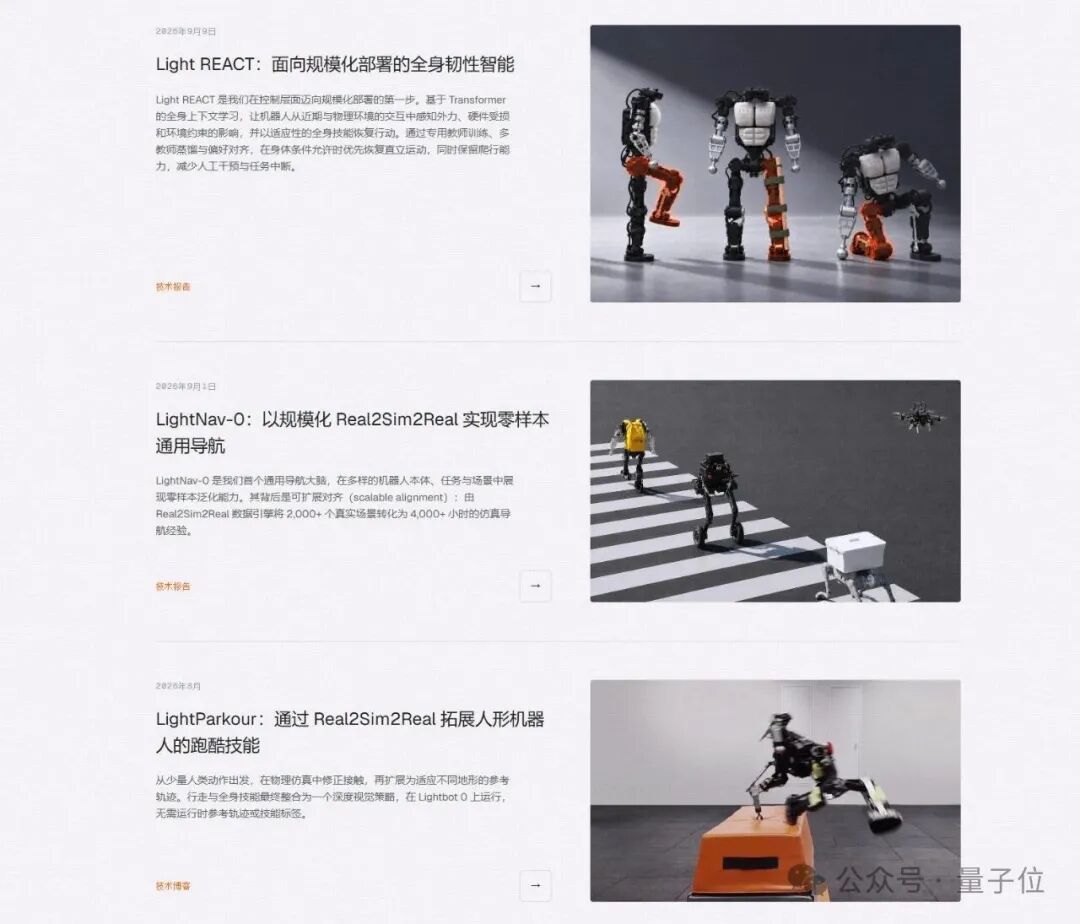
三项技术看似分属跑酷、导航和全身控制三个方向,但放在一起看,亮源新创一直在回答同一个问题:如何让Physical AI从单点能力,逐步形成可规模化训练、规模化对齐和规模化部署的基础模型体系。三者方向不同,却都围绕其“三段范式”展开:规模化预训练、规模化对齐和规模化部署。
过去的机器人研发多建立在任务分解之上,导航、运动控制、机械臂操作各自解决。这套方法在高度结构化环境中已被工业机器人证明有效,但通用机器人面对的是环境、任务、本体乃至自身状态都会变化的现实世界。若每增加一个任务就重新训练模型,每换一个机器人就重新适配,每出现一种异常状态就重新设计控制规则,系统能力增加的同时,开发和部署成本也会同步增长,能力并未真正规模化扩展。大语言模型的意义不只在于把某个NLP任务做得更好,而是通过统一模型、统一表示和规模化训练,让越来越多能力进入同一模型体系。Physical AI若沿类似方向发展,核心同样不是不断增加孤立技能,而是建立可持续扩展能力边界的学习机制。亮源新创将其概括为三阶段:规模化预训练通过大规模数据训练建立基础能力;规模化对齐通过强化学习等方式进一步提升模型能力;规模化部署推动基础模型进入真实世界,并持续产生高质量真实世界数据,形成驱动模型持续优化的数据飞轮。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。