

7名博士生用一个暑假从零训练7B大模型,代码数据日志全公开
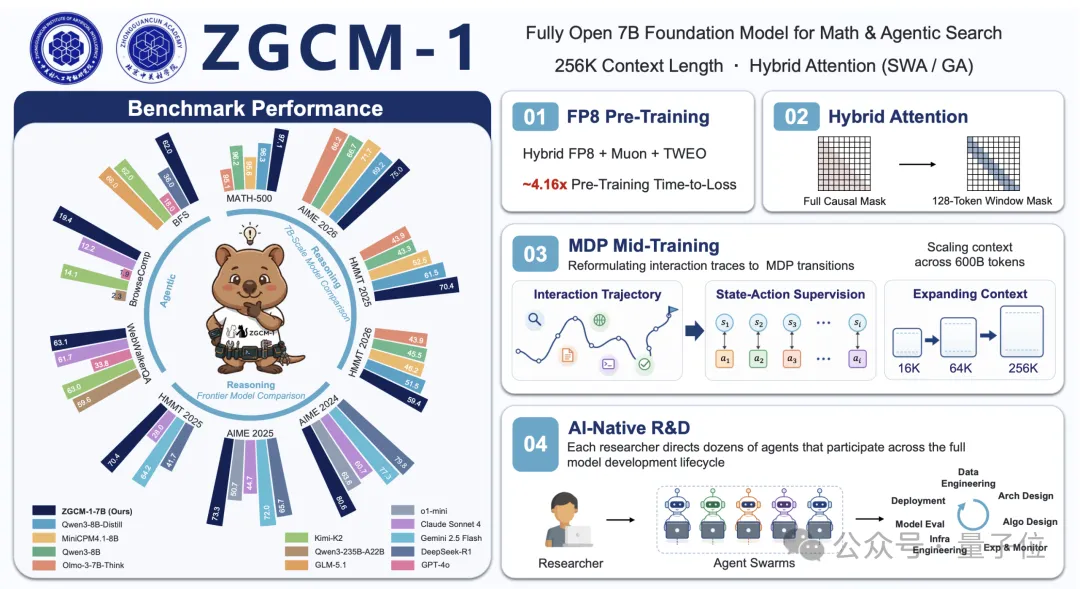
北京中关村学院的7名博士生利用一个暑假,从零训练出7B大模型ZGCM-1。团队随后公开了各阶段训练数据与配方、模型权重、训练代码、中间checkpoint及日志,供研究者追溯和复现整个流程。
在多项通用评测中,ZGCM-1的表现与Qwen3-8B等同规模模型接近;在部分数学推理和搜索评测中,它也能与Qwen3-235B-A22B、GLM-5.1等更大规模模型进行比较。
数据、训练、集群、评测这套工程在大厂通常需要数百人协作,7人如何完成?他们组建了一支由数百个Agent构成的团队,分别负责数据处理、实验运行、日志查看和评测,实践「AI4AI」研发范式。模型训练完成后,团队还对各环节中Agent的实际表现进行了评级,希望基于这次完整训练实践,为RSI现状提供工程结论。
7人最初因兴趣聚在一起:两人来自人工智能方向,两人来自网络方向,其余三人分别来自化学、生物和网安。平时他们多在现成模型上做微调,虽然读过不少技术报告,但对数据如何选择、训练出问题如何排查、报告中的方法经历多少次失败才保留下来等问题仍有困惑。一次吃火锅时,大家聊到这些疑问,萌生了从头训练一次的想法。
他们曾设想用7B模型挑战Sonnet这类模型:参数装不下那么多知识,就让模型多思考,学会搜索和使用工具。至于能走多远,没人有把握,他们想先动手,并留下过程供其他学校的研究者参考。老师们半信半疑,决定让他们尝试,先提供了一些算力。
接下来几天,团队日夜复现已有项目并快速迭代小模型,顺利跑通完整流程,也让老师看到继续投入的可能,从而获得更多资源。真正开始训练7B模型后,他们发现许多东西并未真正弄懂:有些概念在论文里见过,但改代码、解释实验现象时仍会卡住。于是他们让Agent从基本原理开始调研讲解,再回到代码和实验中验证,让知识对应具体实现和训练失败的原因。
遇到觉得干不了的时候,他们把整个工程展开,数据、算法、训练、集群、评测等每一项都对应大厂里的一个专项团队。7人既要推进任务,又要不断补课,问题接踵而至。数据方面尤其如此:数万亿token来自不同来源,质量参差不齐,清洗、去重、检查格式、核对分布,做完一轮还要继续检查。当所有环节同时压在7人身上,工作量远超承受范围。
于是他们开始组建Agent团队。几个人调度数百个Agent,逐渐分出做数据、跑实验和做评测的不同Agent子团队,还搭建了类似论坛的任务发布与汇报系统,让任务有人接、进展有地方看、结果能被检查,并评价不同Agent的工作。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。