

智象未来发布原生全模态视频模型HD-V1,双榜进入全球第一梯队
智象未来(HiDream.ai)推出首个原生全模态视频生成模型 HiDream-O1-Video-1.0(简称 HD-V1)。该模型基于智象自研原生全模态架构,可接收文本、图片、视频等多种模态输入,一键直出 5–20 秒 1080p 高保真视频,并在意图理解、物理规律理解、自主规划叙事及音画一体化生成等维度实现全面升级。
发布同期,HD-V1 在两项国际权威评测中均位居世界前列:
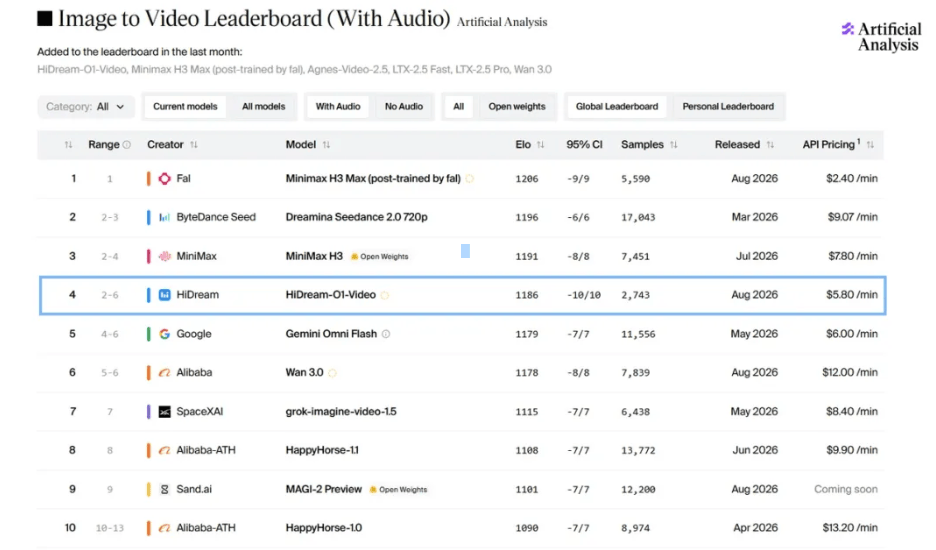
- 在全球领先的独立 AI 基准测试与分析平台 Artificial Analysis Image to Video Leaderboard(With Audio)上,HD-V1 位列全球第四。该榜单以标准化、可复现的基准对全球头部视频生成模型进行系统评测。
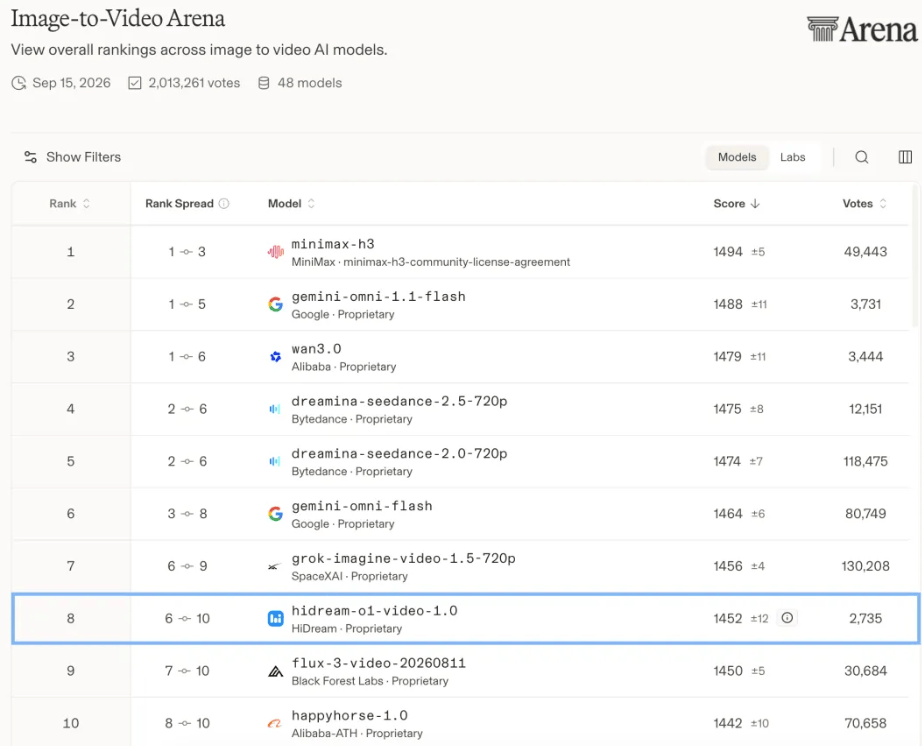
- 在全球最具影响力的 AI 模型盲测评测平台 Arena.ai Image-to-Video 中,HD-V1 排名第八。该平台是专注于 AI 视频生成模型的盲测评测子平台,被全球主流 AI 厂商广泛引用。
智象未来 CTO 姚霆表示:“HiDream-O1-Video-1.0 是智象原生全模态世界模型矩阵的关键组成部分。我们始终相信,视频生成的代际进化不仅仅是像素的提升和时长的延续,而在于模型是否真正理解创作者的意图和真实世界的物理规律。HD-V1 从架构设计之初便面向文本、视频与音频的统一表征,原生全模态技术使之从‘看得清、动得顺’,迈向‘听得懂、说得准、演得连贯’。这次在两项国际权威榜单中再次进入第一梯队,是对智象原生全模态技术路线最直接的验证。”
视频生成的难点往往不在“会不会画”,而在“有没有听懂”。用户输入常为口语化、碎片化、模糊化信息,直接输入模型易出现意图漏解、镜头跳戏、人物漂移与音画错位等问题。为此,HD-V1 前置多模态意图理解模块,借助多模态理解模型对视频内容进行结构化规划,涵盖镜头时长、场景地点、画面内容、首帧约束、在场角色、动作与表情、景别构图、运镜焦段、台词与背景声等音效设计等字段,确保模型充分理解用户自然语言输入的意图,并转换为模型可接受的专业表达。
理解意图只是第一步,HD-V1 的另一重要突破是“更懂物理”。物体在重力作用下如何落下、碰撞如何反馈、惯性如何延续、光影如何衰减、空间如何保持连续,这些物理规律既被理解,也被写进视频模型的叙事之中,成为画面生成的底层逻辑。当物理规律进入生成逻辑,画面的真实质感得到全面提升。以下三组 demo 是在同样的提示词下,三款业内顶级模型生成的视频对比,第三个 demo 为 HD-V1 生成(全文均同)。
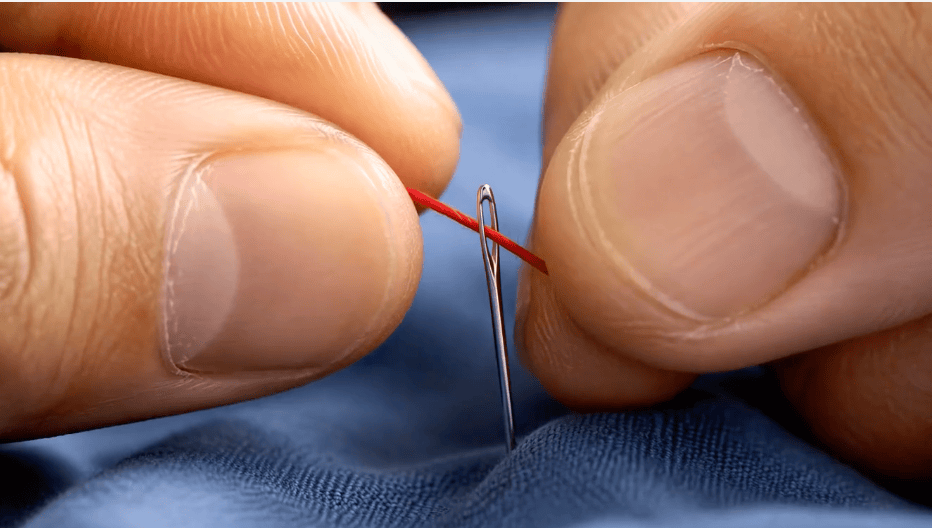
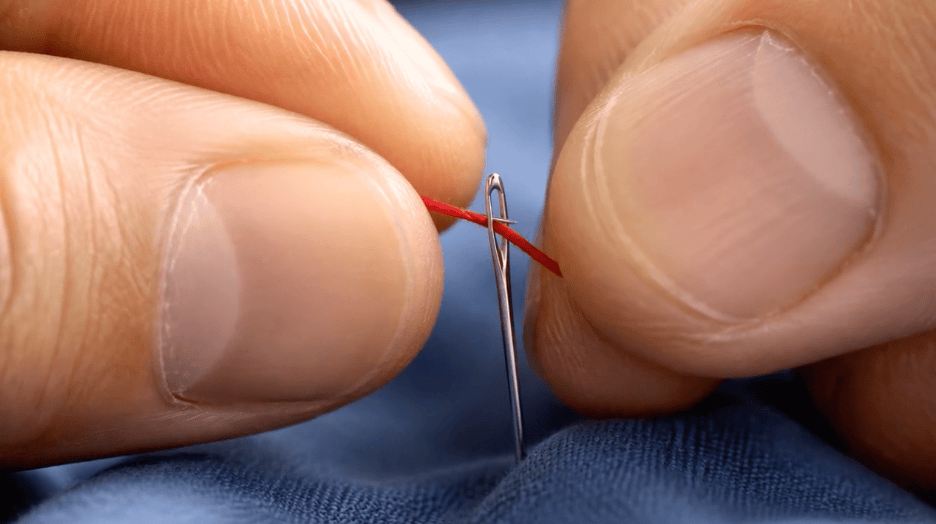
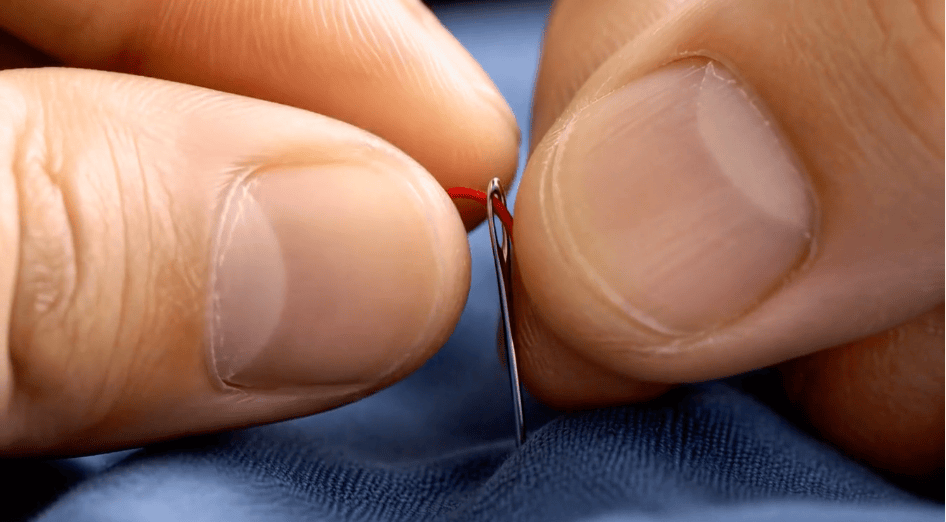
模型一的画面中,双手相向发力,红线产生了向内缩短的“不合理”现象;模型二则突兀地凭空生出一根针。而 HD-V1 生成的画面截然不同:双手相向发力时,红线自然隆起,与模型一形成鲜明对比;当左手拇指向外轻捻线头,红线便随手的发力顺势延展,张力、走向与形变皆贴合真实物理。而且画面还有着极佳的真实质感,指甲的纹理,针的金属感等都表现得非常真实,甚至从中能感受到线的柔韧。
02.画面高保真、叙事连贯性、人物一致性全面升级
针对高保真画质、叙事连贯性与人物一致性等关键指标,HD-V1 实现了全面优化升级。它不只追求单帧画面的精美,更要让视频内容在整体叙事维度上自洽。
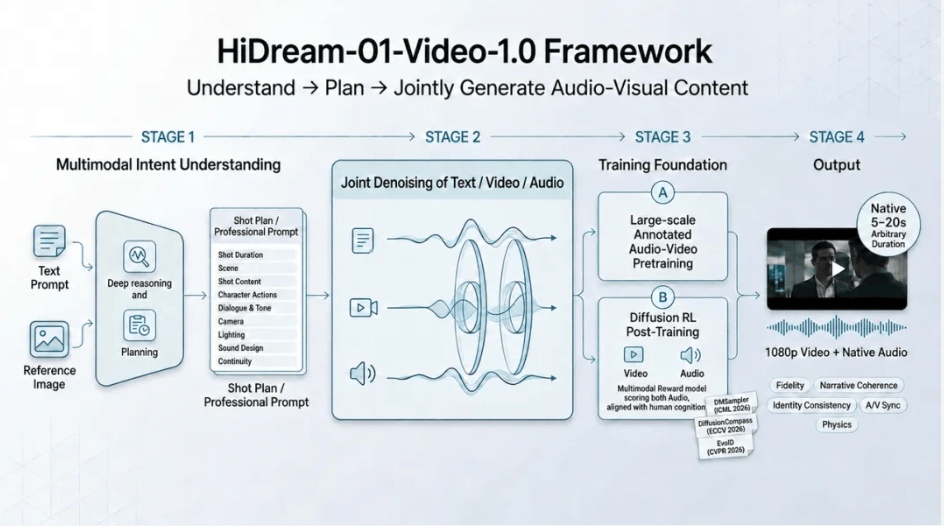
当人物、情绪、动机、物理规律,一旦进入连续镜头,就必然互相影响。为此,智象提出了“先规划、后联合生成、再以多模态 Reward 对齐”的技术思路,让模型先在全局层面规划叙事与角色状态,再在联合生成中约束画面、动作和语义,最后用多模态奖励信号对齐画质、连贯性与物理合理性。
03.服从叙事内容视频生成时长的逻辑革新
多数视频生成时长遵循的是固定提示词路线,比如用户在提示词中输入生成 5 秒,模型只能在这个时间窗口内填充内容,内容叙事“被迫”适应时长。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。