

大模型记忆交给CPU,长上下文推理瓶颈有了新解法
用Agent做Coding已经不算新鲜事。但如果把视线从聊天窗口移到背后的数据中心,情况就复杂得多。
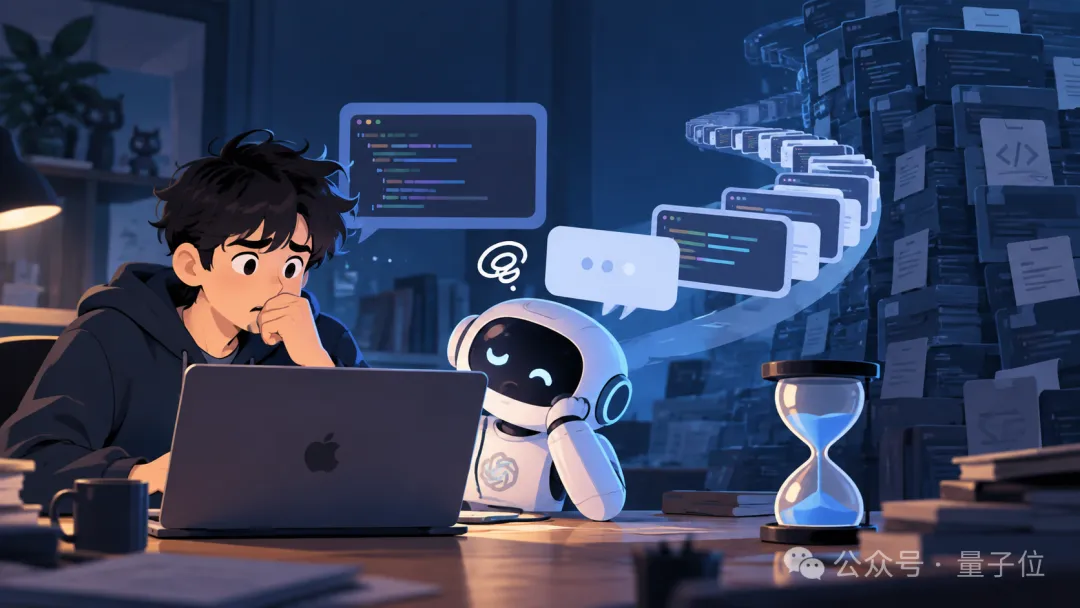
一个Coding Agent要修复横跨十几个文件的bug,需要反复读代码、查资料、跑测试。前几轮交互或许还很顺畅,可任务持续运行,系统要处理的历史信息会越积越多。当成千上万个Agent同时这样工作,运营方就可能面临一个棘手问题:服务器仍在运行,能承接的并发却越来越紧张,有些请求连输出第一个Token都要等上许久。
模型没变,服务器也没变,问题的根源出在记忆上。大模型每生成一个新Token,都要继续使用前文信息。为了不必每次从头计算,系统会把此前算好的中间结果保存下来;会话越长,这份记忆就越厚。一旦显存装不下,部分缓存被清出,等Agent下一轮又需要这些历史信息时,就可能重新做一遍Prefill,前面已经算过的内容又得再花GPU时间算一次。
尤其在Agent时代,AI很少只做一问一答,更多是反复思考、规划和行动的任务,期间会不断积累会话历史、检索证据、工具结果和中间状态。于是,一个过去藏在大模型推理内部、普通用户几乎感知不到的东西被推到了台前:KV Cache。
它的特点就是一个字:大。但运营方又不能为了省空间,任由已算过的内容反复占用GPU重算。因此,长上下文推理要算的账,从算力延伸到了存储、搬运和复用。而破局之道并不是GPU,而是CPU。
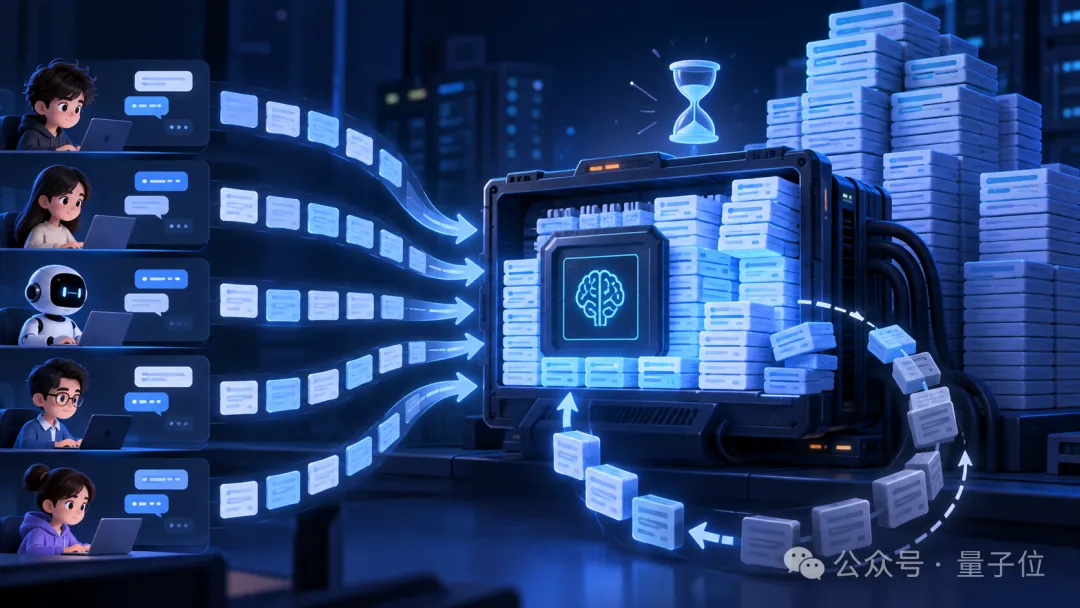
对于采用因果自注意力的Transformer模型,前面处理过的Token会在注意力层中留下对应的Key和Value。模型生成后续Token时,还能继续使用这些结果,推理系统将它们缓存起来,就形成了KV Cache。可以把它理解成模型读书时做的笔记,后面再遇到需要联系上文的地方,模型可以调用笔记,省去对已有Token的重复计算。这里说的记忆,指的是推理过程中留下的中间状态,模型权重并没有因此改变。
这份笔记确实能省计算,但它也实实在在占地方。Agent读的东西越多,服务器要替它保存的笔记往往就越厚。以Qwen3-8B为例,按照公开模型配置,在KV Cache采用BF16或FP16、每个数值占2字节的条件下,每个Token对应的KV数据是147456字节,约147KB,这还没有计入缓存管理等额外开销。一个Token之所以带出这么大一份缓存,是因为系统保存的并不是这个Token的文字本身,而是它在多层注意力计算中对应的Key和Value。按该模型结构,计算式为:2份K/V × 36层 × 8个KV头 × 每头128维 × 2字节。
仅借用这个每Token开销做一次百万上下文的容量推演:如果需要缓存100万个Token,对应的KV数据约为147GB。注意,这里的1M是测算假设,不代表Qwen3-8B实际支持百万上下文;其官方说明是原生32768 Token,采用YaRN可扩展到131072 Token。单个请求已经如此,如果把请求规模也放大呢?假设一个服务有300万日活用户,每人每天发出10个请求,且每个请求都按前面的1M上下文计算,一天就是3000万个请求。先不考虑压缩和共享复用,按每个请求约147GB全量累加,对应的日累计KV数据规模就是:300万 × 10 × 147GB ≈ 4410PB。如果日活再增加到3亿,相同假设下,这个数字还会放大100倍,达到约441000PB,也就是441EB。
不过,这里得分清两件事:一天的请求累计涉及多少KV数据,和数据中心同时需要存下多少KV数据,不是一回事。上面是每次请求都独立、全量计数的规模推演,不能直接当作存储采购清单。实际要配多大的缓存池,运营方还得看高峰时有多少请求同时运行、缓存要留多久、哪些前缀能够共享,以及压缩和淘汰策略。已经复用的同一份缓存,也不该因为被请求多次就重复占一份容量。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。