

华为汪涛:AI算力竞争走向系统工程,一年一代芯片节奏已打通
华为今年全联接大会公布了一组芯片时间表。昇腾960DT研发进度较原计划提前三个季度,单芯片算力实现倍增,支持2 PFLOPS FP8、4 PFLOPS FP4,HBM容量最高288GB、带宽9.6TB/s。对应的昇腾960超节点可做到4096张NPU卡,最高8 EFLOPS FP8算力、超过1PB HBM容量。按照规划,2028年推出昇腾970、2029年推出昇腾980,未来几年保持“一年一代”的演进节奏。
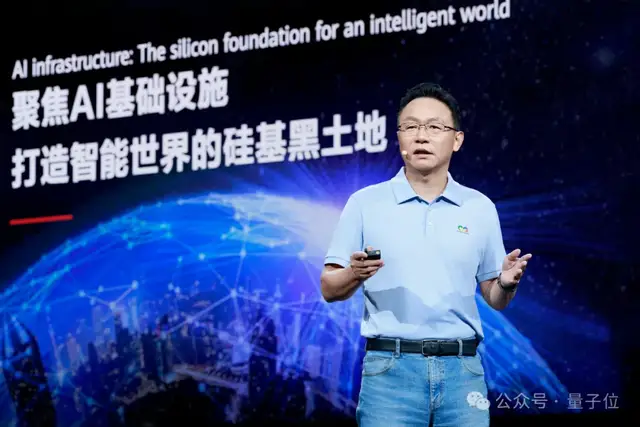
会后,汪涛在接受量子位专访时表示,从今年开始,950、960、970、980连续几代将坚持一年一代,进入快速演进节奏。这一节奏得以实现,是因为国内半导体制造、封装的上下游配套已经全部打通。
围绕昇腾960,华为同时展示了NPO光互联、超节点、CANN生态和韬定律,指向的结论是:AI算力竞争已越来越接近一场系统工程。相比上一代,960在算力、内存容量和带宽上继续提升,产品节奏也明显加快。汪涛透露,960DT比原计划提前三个季度准备就绪,960PR版本也将继续提前,960芯片已在实验室测试数月。
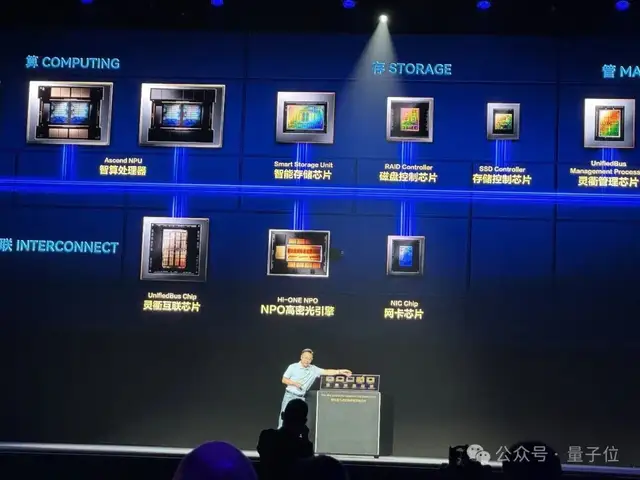
AI大模型训练和推理规模迅速扩大,单颗芯片难以独立承担万亿、十万亿参数模型的计算需求。华为超节点从910C的384卡、950的1024卡,扩展到960的4096卡,并通过跨物理节点的统一内存编址,让多颗NPU互联后更接近一台逻辑计算机。汪涛称,从仿真训练看,在同样十万卡集群下,4096卡超节点组成的集群相对传统八卡服务器组成的集群,MFU可提升2.75倍。
汪涛因此反复强调,AI基础设施已进入系统工程阶段,只做好一颗芯片、只做一台服务器都不够,最终要交付一个高可用度的复杂系统才有价值。大规模超节点同时涉及芯片、通信、IP网络、光互联、供电、散热、软件和故障管理,单点性能强并不代表系统能长期稳定运行。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。