

浪潮信息破解智算能力天花板与产能焦虑
过去,业界普遍认为只要计算卡数量足够多、集群规模足够大,就能占据算力优势。但如今,算力是否够用已无法单靠堆卡解决,问题正分化为多个层面。
其中,智能上限关注算力能支撑多强的智能。前沿模型的参数规模、上下文长度和推理深度同步增长,Agent可能连续运行数小时乃至数天。模型能否装入单机、运行速度是否够快、长时间运行是否稳定,都需要重新评估。智能规模则关注算力能以多低成本生产多少智能。Token需求爆发,推理负载日益多元,Prefill与Decode的计算特征不同,堆叠同一种算力已无法覆盖这些差异。
在AICC 2026上,IDC发布《2026年中国人工智能计算力发展评估报告》,对这两个方向进行了拆分阐述。Agent大规模爆发后,AI对算力的需求正发生质变。过去算力调用呈脉冲式,用户提问、系统回答,仅调用一次算力。而Agent接管任务后,一个人类意图可能触发几十次甚至几百次连续推理;多个Agent组成协作网络后,系统连续运转时长可进一步增至数小时甚至数天。原本短暂的算力请求,正变为持续不断的计算负载,给基础设施带来新压力。这种长流压力可拆解为三个影响因子,以乘法形式叠加,将算力需求增长曲线推至前所未有的高位。
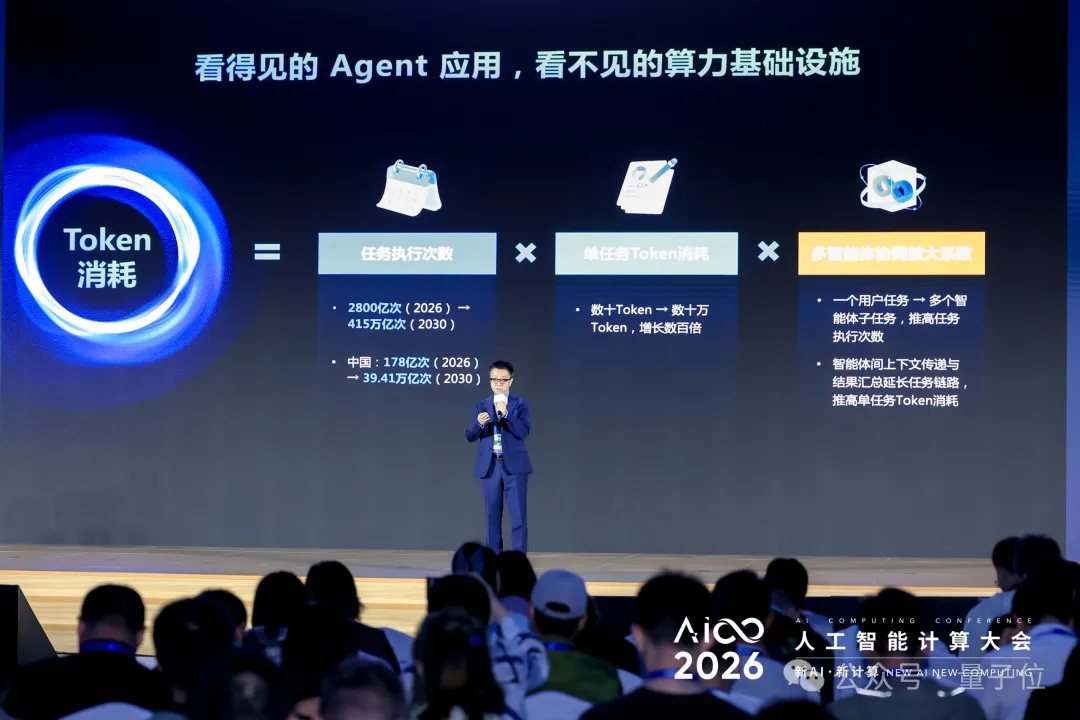
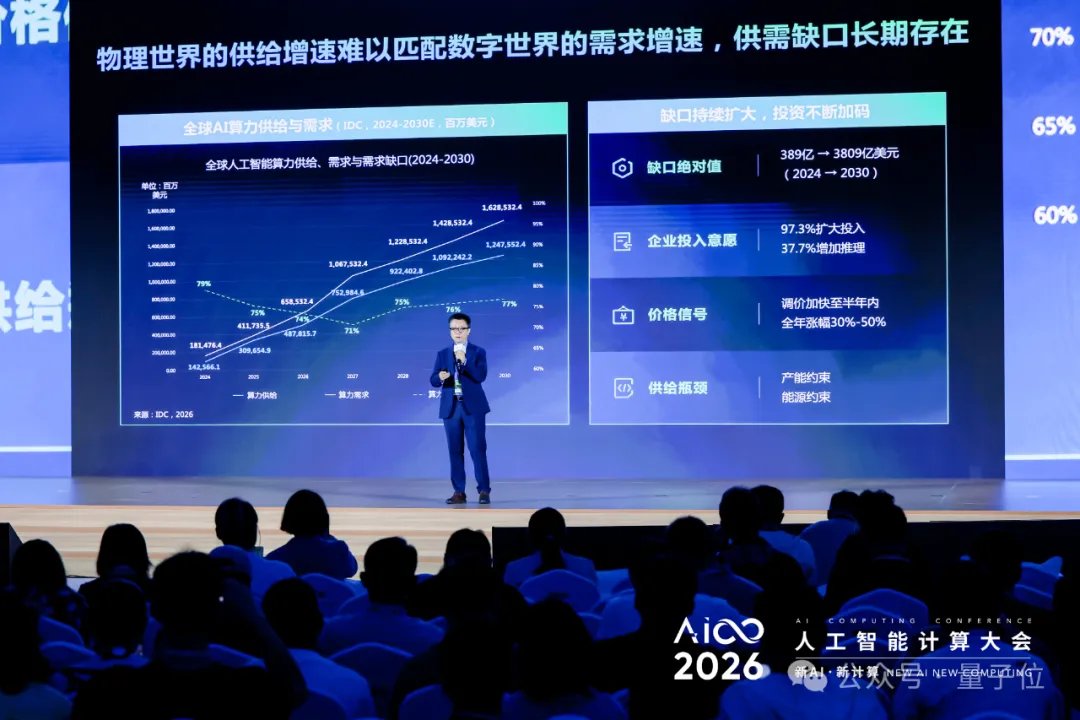
IDC数据显示,从今年到2030年,全球Token消耗量复合增长率将达4822.6%,Agent消耗的Token正急剧膨胀。但算力供给增速滞后于需求变化。IDC报告显示,全球AI算力需求满足率从2024年的79%一路下滑,2027年预计跌至71%,即便此后上游半导体供应链压力缓解,到2030年也只能恢复到77%左右。百分比波动看似不大,但需求基数急速膨胀,到2030年,算力缺口绝对值将达3809亿美元,扩大到2024年的近十倍。
过去,弥补缺口主要靠“大力出奇迹”,即通过集群规模扩展堆叠更多算力。但Agent时代的推理负载种类繁多,对算力设施要求各异。Prefill阶段是高并行、高计算密度任务,Decode阶段需逐Token串行处理、更依赖内存带宽,Attention需频繁访问不断增长的KV Cache,MoE包含稀疏计算和大规模路由调度,多模态模型还有独立的Encoder模块……
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。