

诺因发布GLOW技术报告,机器人一次教学就能跨场景复用
以往让机器人掌握新任务,通常需要重新采集数据、编写固定流程或进行针对性训练。这种方式能应对确定性较高的任务,但面对真实场景中不断变化的物品、环境和需求时往往难以覆盖。
近期新一代通用大模型GPT-6 Astra发布后,行业对具身智能技术路线展开广泛讨论。有观点认为通用大模型正展现出操控机器人的能力,可能对既有路线形成冲击;同时业内也逐渐形成共识:自回归架构正成为模型架构的收敛方向,具身智能的竞争核心将转向数据与学习方式。
9月24日,诺因(Knowin)发布面向通用具身智能的生成式学习架构GLOW技术报告(报告链接: https://knowinai.com/tech.html#section-2),完整介绍了GLOW全新升级的整体技术架构,呈现了一条将通用认知能力转化为可靠物理行动的可行路径,核心突破在于实现了机器人“一教就会”的任务学习能力。
报告提出,GLOW将改变机器人学习新任务的方式:把人的一次完整操作、当前环境、机器人自身状态与执行历史放在同一条链路中理解,让机器人不只是看见动作画面,而是同时捕捉物体、空间关系、动作顺序和状态变化,从“看过”进一步走向“学会”,拥有跨物体、跨环境、跨任务复用的通用能力。
报告还披露了GLOW的多项评测结果。从物理任务执行到具身场景理解,诺因已经连续拿下三项第一,印证了其长期坚持的自回归技术路线的前瞻性,以规模化物理经验训练模型,以统一架构协同认知与行动,以闭环执行适应环境变化,从而以完整的具身能力走向物理世界。
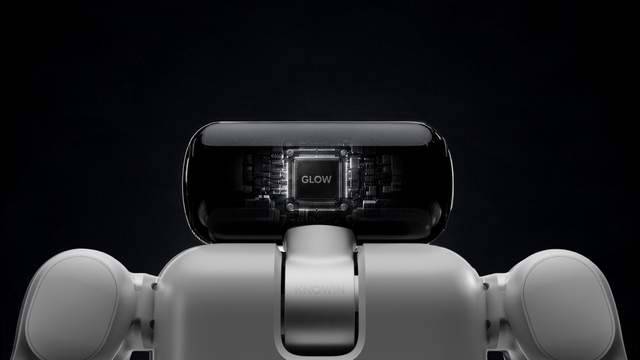
GLOW的目标是让机器人获得跨物体、跨环境、跨任务复用的通用具身能力,而非为每项任务单独学习一套策略。用户不必把需求拆解成机器指令,也不必受限于出厂时写好的功能清单。机器人可以通过一次完整操作理解任务,再把画面、物品关系、状态变化与执行反馈转化为行动。从开盒收纳、浇水,到擦桌、调酒等各类家务工作,这一能力都得到了验证:
- 开盒收纳包含开盖、放物、合盖三个核心步骤。GLOW会根据实时画面定位盒盖、物品和盒内区域,按照人类的操作逻辑完成整套动作。人类的操作只定义任务目标和操作顺序,实际执行时,机器人会根据现场的盒子大小、物品位置调整姿态和路径,即使更换了不同的盒子、不同的物品,机器人也能顺畅完成收纳,不用重新教学。
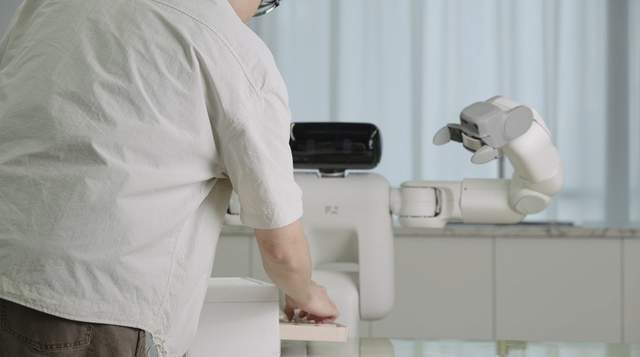
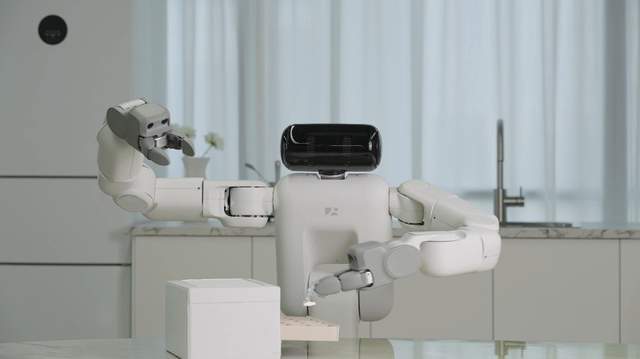
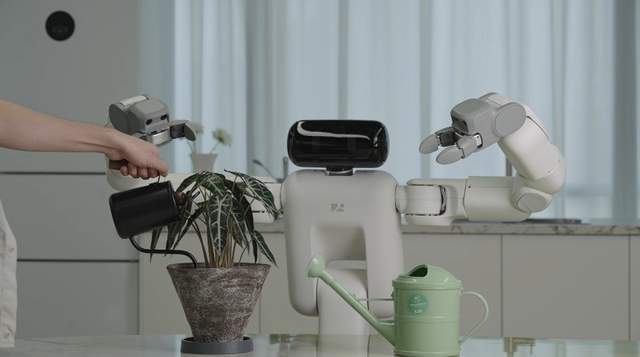
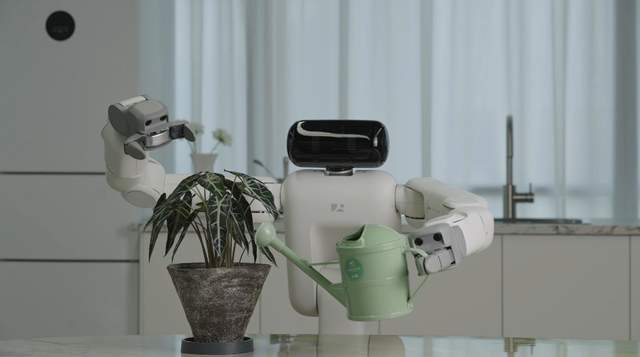
- 浇水任务中,人类教学用的是黑色细嘴壶,实际执行时换成绿色浇水壶,机器人依然能顺利完成。GLOW会把人类演示过程中的抓握方式、对准角度、倾斜幅度等核心逻辑,映射到眼前的新器具上,自主调整抓取位置和动作姿态。每完成一步都会根据实时画面更新状态,后续动作随现场情况动态调整。
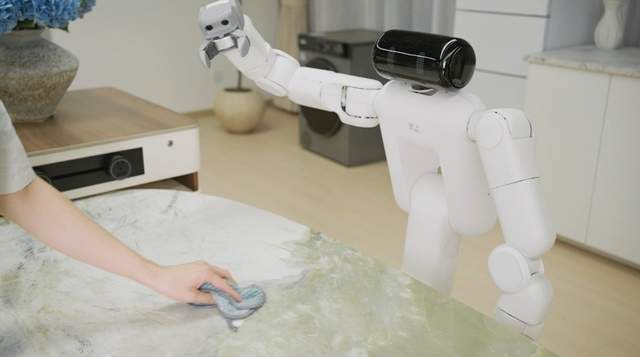
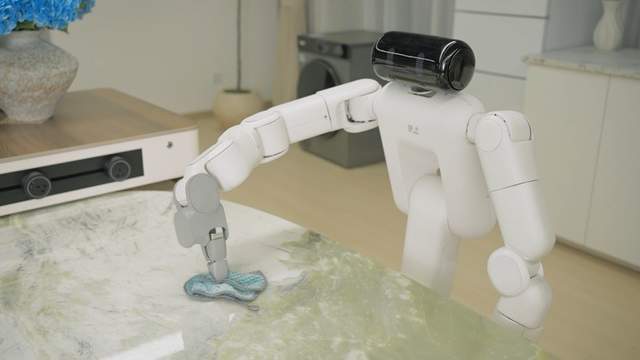
- 在擦桌任务中,人类用户沿着心形轨迹移动抹布;机器人看过一次后,就能复现同样的心形擦拭动作。这意味着,GLOW不只是学会了“擦桌子”这项任务,还能捕捉到“怎样擦”的个性化操作特征。用户只需一次操作教学,就能把自己的操作偏好传递给机器人,让机器人按自己习惯的方式完成家务。
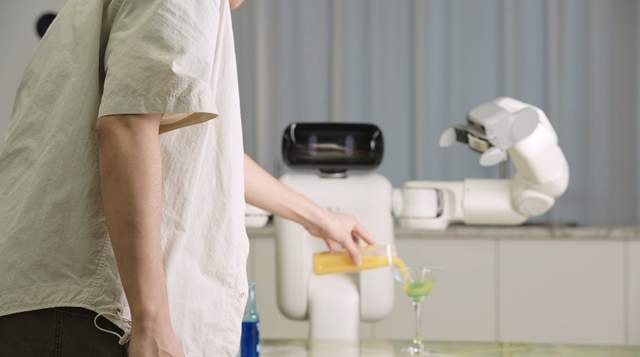
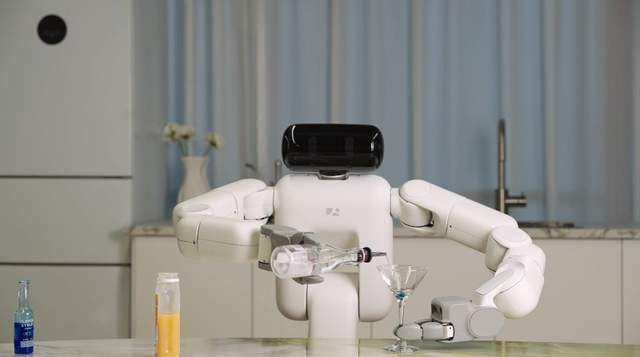
- 调酒:多杯多步骤的复杂流程,也能按序连贯完成。面对多个酒杯的调酒场景,GLOW能从人类操作中,识别出每一步的操作对象、倾倒关系和先后顺序,再结合现场画面找到对应的酒杯,依次完成取杯、倾倒、回正、放回的完整流程。人类的行为只提供了任务的顺序逻辑,实际执行时机器人会自主匹配当前场景,保证多步骤任务连贯推进,不会混乱。
四大模块协同:构成从经验学习、任务理解到行动反馈的完整链路
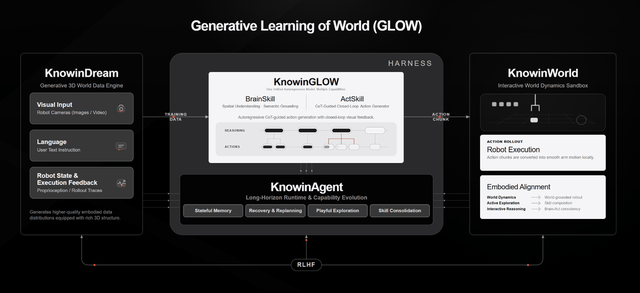
“一教就会”的背后,源于GLOW全新升级的技术路径。通过将原有的Brain与Act能力统一到多模态自回归模型KnowinGLOW中,让视觉理解、空间推理、任务规划与动作生成能够在同一模型内协同完成;KnowinDream负责生成物理交互经验,KnowinWorld用于模拟动作可能带来的结果,KnowinAgent则围绕任务记忆、工具调用、反馈和重新规划组织执行。由此,GLOW形成了从经验学习、任务理解到行动反馈的完整链路。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。