

清华和无问芯穹开源 RLark,具身设备纳管缩到 5 分钟
飞机在空中按序飞行、准点起降,表面看只关乎飞机本身,背后却离不开机场、跑道、航线及地面资源系统的持续协同。塔台的价值正在于此:把分散的飞机与地面、空中资源组织起来,让每架飞机按各自任务有序运行。飞机数量增多、航线愈发复杂,统一管控与协调的重要性也随之上升。
一项具身任务同样涉及多个角色的配合:机器人、相机等现场设备,云端算力,训练与推理程序,以及连接各方的通信与运行环境。更多机器人进入研发和应用后,协同的复杂度与成本会进一步放大。设备需逐个接入,任务需分别部署,云端与现场要反复配置网络,设备、网络或程序出现异常还需逐一排查。机器人从单机走向机群,具身智能也需要一座新的塔台:把设备接进来只是第一步,还要统一组织管理分散的算力、设备和执行程序,让它们围绕同一任务高效协同。
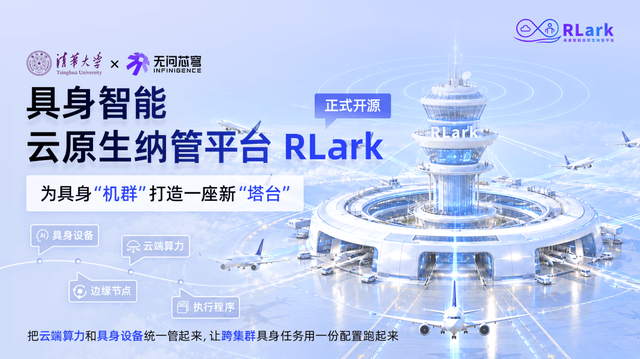
针对这一问题,清华大学与无问芯穹联合打造并开源了面向具身智能的云原生纳管平台 RLark。平台以自研的具身设备运行时(embodied-runtime)和任务级跨集群网络互联技术为核心,打通真实设备统一调度与跨地域任务互联运行两个关键环节。一方面,统一管理机器人、相机等具身设备的运行时环境,让设备能像 GPU 一样被申请、调度和复用;另一方面,针对不同任务与网络流量特征,对跨集群通信做任务级隔离,并优化大小包传输性能,提升云端与现场协同效率。
RLark 可将云端算力、边缘节点和具身设备纳入统一资源体系,并以一项完整任务为单位组织运行,使一次实验中完成的接入、部署与通信配置能在后续任务中复用。运维人员通过一行命令即可接入并统一管理设备,研究人员通过一份任务配置即可将训练、推理和真机交互程序部署到不同集群。目前,RLark 已完成 3 个集群、近百个云边端节点的统一纳管,覆盖 4 种型号的具身设备,设备纳管从小时级缩短至约 5 分钟,任务提交后可在 10 秒内启动运行。同时,RLark 进一步结合训练框架,打通了跨地域的采集、训练与真机验证闭环,为具身智能实验走向更大规模设备与更复杂协同场景提供基础支撑。
RLark 将从用户界面、API、后端服务,到任务编排、跨集群互联和具身设备运行时的整套能力开放出来,降低具身基础设施的使用门槛,让更多团队可以直接部署和使用。
开源地址: github.com/RLinf/RLark
项目文档: rlark.readthedocs.io
快速开始: github.com/RLinf/RLark#quick-start
为验证云端算力与现场设备能否围绕同一任务协同运行,团队将 RLark 与强化学习基础设施框架 RLinf 结合,在广东云端 GPU 集群与北京机器人现场之间完成了一次跨地域真机实测。实验同时涉及现场机器人与相机、云端 GPU,以及训练、推理和真机交互等多个执行角色,重点验证的不只是设备能否连通,而是 RLark 能否让原本需要多处配置、多个程序协作的复杂实验更快准备、更简单运行,并形成完整的采集—训练—验证闭环。
- 5 分钟完成设备纳管:让云和端的资源可被统一申请
实验准备阶段,运维人员先将云端 GPU 集群与现场设备所在集群接入 RLark,由各集群 Agent 同步节点容量、资源信息与运行状态。随后,通过具身设备运行时(embodied-runtime)接入已适配的双臂机器人与相机,将真实硬件注册为任务可申请、可调度的资源。在测试环境下,具身设备纳管从传统的 1 小时骤降为 5 分钟。完成接入后,研究人员可在平台中统一查看两地资源的位置、类型与可用情况,并在后续实验中持续申请和复用,无需每次重新接入设备。
- 10 秒内启动任务:用一份任务配置组织两地执行
资源准备就绪后,研究人员通过一份任务配置定义训练、推理和真机交互等执行角色,声明各角色所需的资源、实例数量与部署位置。例如,训练角色使用云端 GPU,真机交互角色申请现场机器人与相机,共同归属于同一项具身任务。
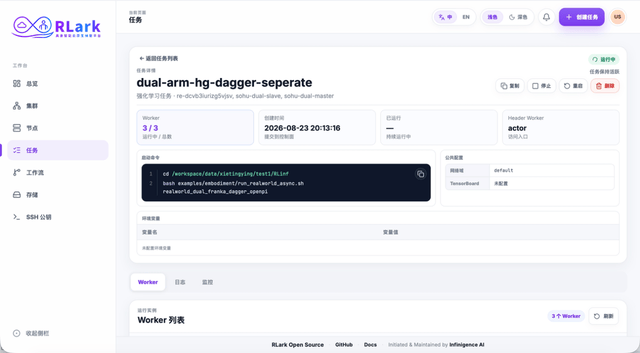
任务提交后,RLark 将配置下发至相应集群,由 Agent 创建执行实例,并建立实例之间的跨集群通信关系。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。