

索辰科技与美梦空间发布物理世界模型及评测基准
具身智能商业化正面临瓶颈。北大与BeingBeyond联合发布的BeTTER基准(ECCV 2026)显示,最先进的VLA模型在标准静态测试中表现尚可,但引入空间布局偏移或时序外推等干预后,成功率断崖式下跌。斯坦福大学另一项研究则指出,在接触丰富任务中,VLA存在“精度失效”与“力失效”两个相互独立的失效模式。
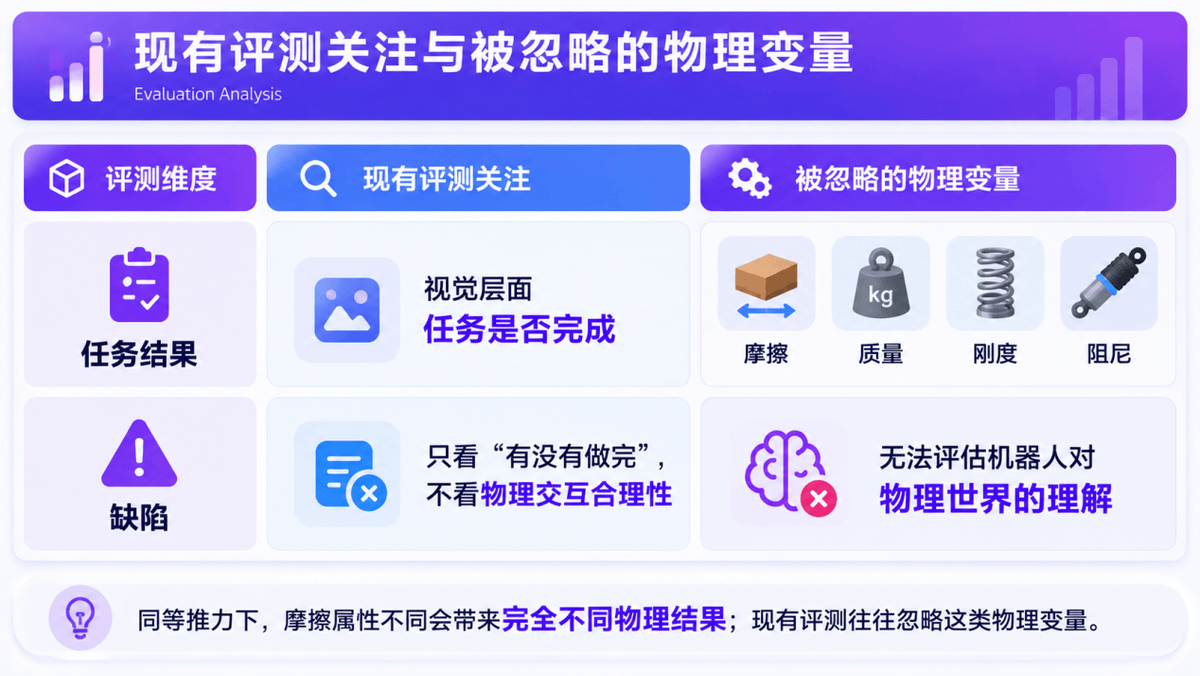
VLA驱动的机器人只知道“看到杯子就该抓”,却不知道“杯壁有多薄、摩擦力够不够、注水后重心会不会偏”。它本质上是统计学模仿者,而非物理世界的参与者。当VLA的局限逐渐暴露,“世界模型”开始成为具身智能跨越商业化“奇点”的新叙事。
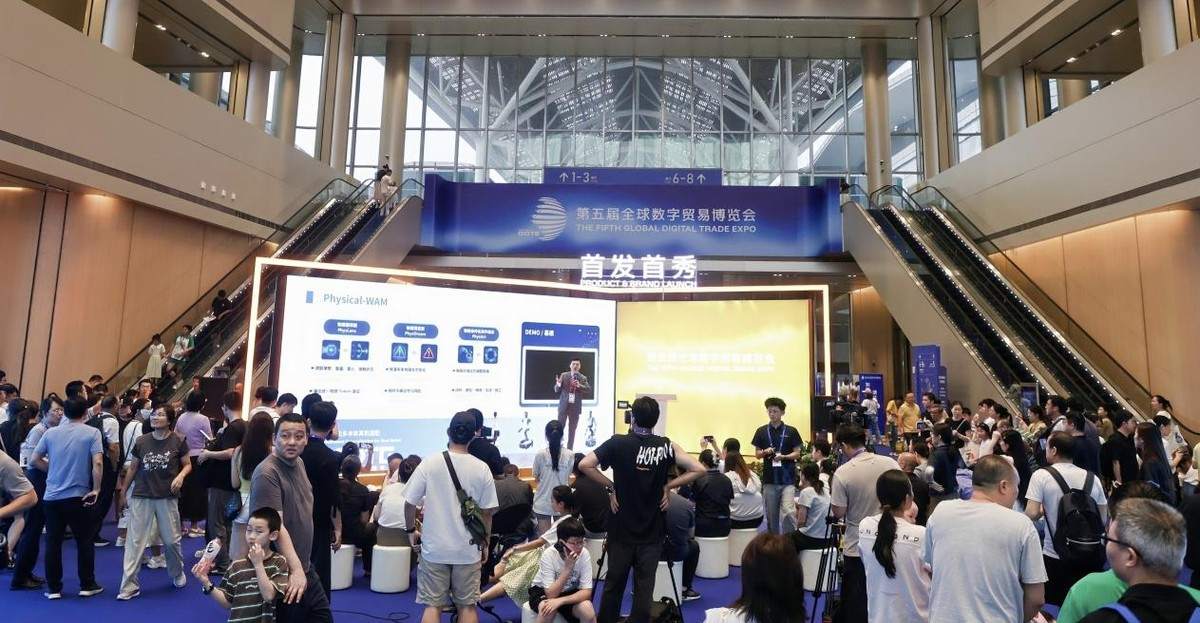
9月26日,美梦空间CEO李明昊在第五届全球数字贸易博览会首发首秀主舞台上,首次公开并正式发布Physical-WAM、RoboTwin-Phys两项重要成果
第五届全球数字贸易博览会上,杭州美梦空间科技有限公司(Memo)为具身智能补上了这堂“物理课”。其发布的Physical-WAM是全球首个具备物理感知能力的物理-世界动作模型,RoboTwin-Phys则是业内首个物理漂移评测基准——前者让机器人“懂物理”,具备人类式的预判能力,后者验证它是否真的“懂了”。
美梦空间专注于世界模型的研发与应用,由北京大学信息技术高等研究院高文院士领衔的AVS先进视觉系统研究中心孵化,核心团队在具身智能、视频编解码、空间计算、人工智能领域积累了深厚的研究经验。2026年8月,物理AI头部企业索辰科技(688507.SH)完成对美梦空间独家种子轮战略投资,双方在数据、算力、物理AI等技术层面深度协同,共同推进世界模型研发与产业应用落地。Physical-WAM和RoboTwin-Phys正是双方携手给业界带来的一张新答卷。
Physical-WAM:让具身智能“理解”物理
具身智能向前推进时,首先撞上的是训练信号的源头。计算机视觉与大语言模型领域获取训练样本的边际成本较低,网页文档、图片视频可以通过互联网获取标注。
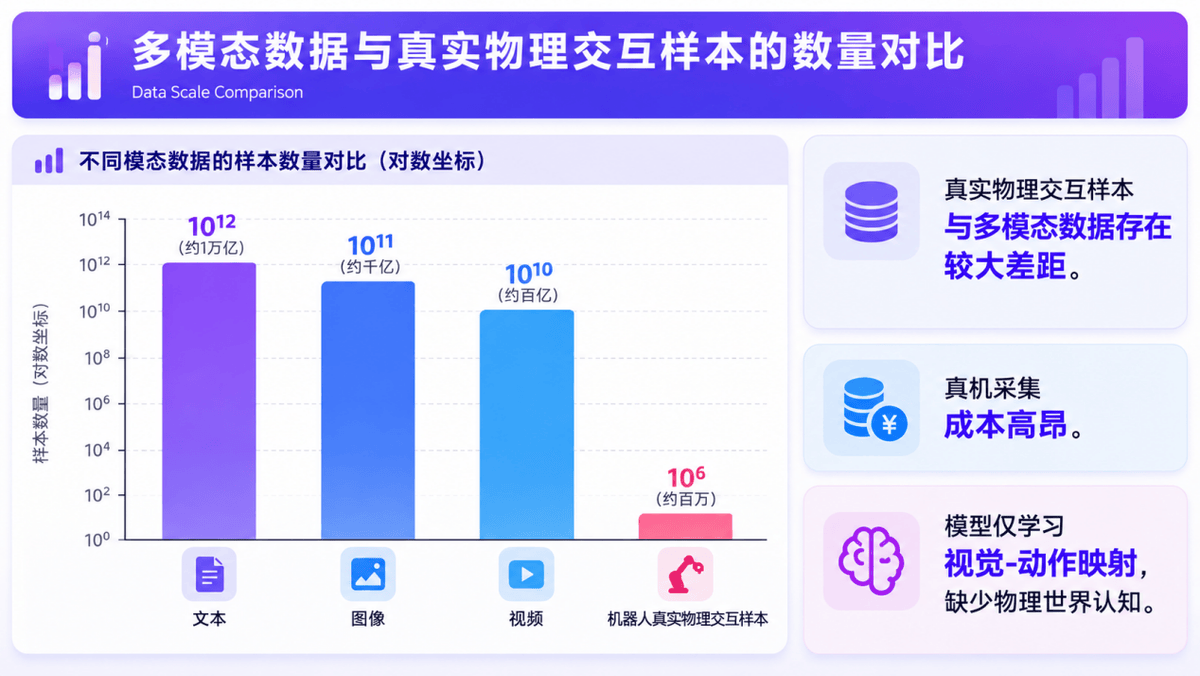
机器人与文本、图像、视频相比,训练数据与样本稀少
机器人物理交互数据的生产逻辑则完全不同。有效的物理交互样本诞生于真实或高保真仿真的接触过程:抓取、推拨、按压,每一次有效交互都伴随真机运动、接触反馈和物体状态改变。这类数据采集周期长,硬件损耗成本高,不同机器人本体之间还存在明显的数据迁移壁垒。由此形成客观现实,机器人可用的真实物理交互样本仅维持在百万量级,和文本图像领域数十亿级别的数据体量相比,存在数万级别的落差。
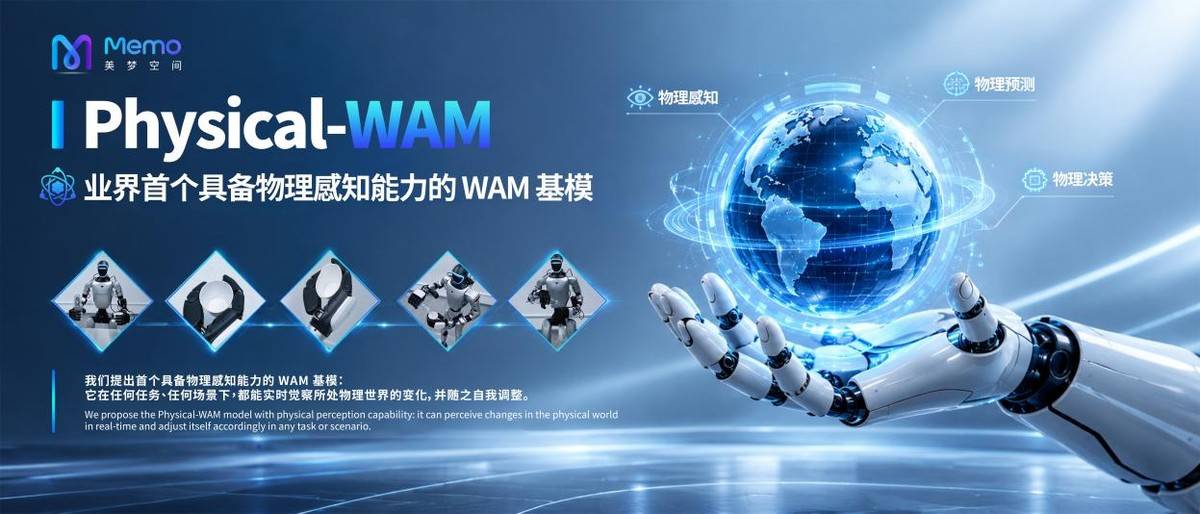
面对数据供给的现实约束,美梦空间提出Physical-WAM作为针对性解法。整套架构的核心设计,是在感知信号输入和动作输出链路之间,插入一层“物理Token”表征。传统世界模型的中间表征是像素或隐空间向量,它虽然可以推演物理世界的演化,但无法感知物理本身——知道“下一帧画面会变成什么样”,却不知道“为什么会变成这样”。Physical-WAM作为业内首个具备物理感知能力的WAM基模,基于可观测数据与深层物理数据训练,能在真实任务中实时觉察物理变化,并预判动作后果、实时修正行为。
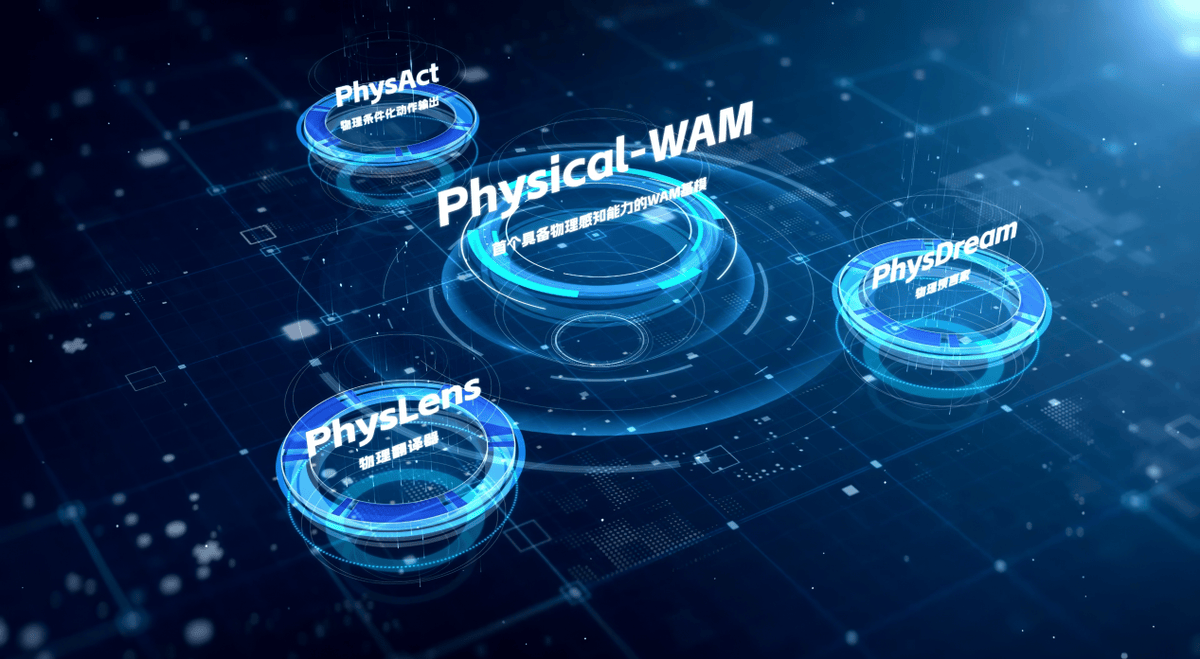
Physical-WAM由PhysLens、PhysDream、PhysAct三个模块构成,形成“感知→预测→生成→修正”的反馈链条。PhysLens是“物理翻译器”,从多模态感知信号中提取摩擦、重量、重心、接触状态等不可直接观测的物理信息,输出统一的物理Token表征。对照来看,现有VLA学到的是反应式的观测到动作映射,模型知道何时该伸爪、旋转或松手,却不显式推断物体有多重、表面是否湿滑。PhysLens要补的正是这层显式估计。PhysDream是“物理预言家”,结合当前物理表征、环境状态和候选动作推演未来物理状态,预测打滑、脱手等风险并给出不确定性评估。PhysAct则负责物理条件化动作生成,把物理属性与未来状态预测引入动作生成,当环境发生物理漂移时自动调整执行策略。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。