

具身智能补数据产线,云栖大会聚焦全栈工程能力
数据短缺只是具身智能面临的难题之一。真机采集成本高、周期长,规模化落地门槛不低;即便获得物理交互样本,要将其转化为机器人能力仍有不小距离。
国际方面,Tesla Optimus借助工厂场景的真机遥操,快速积累万级episode数据;Figure AI与英伟达则重点投入仿真合成与世界模型,尝试用「数字孪生」绕开物理采集的成本限制。国内头部具身智能企业也在自建数据工厂,从UMI手持采集到EgoCentric第一视角视频,拓展可用数据的来源与规模。
各方重视数据的原因在于,数据不足难以涌现真正的智能。但具身智能的数据问题不能只看数据本身。AI正从Intelligence走向Action,进入物理世界后,具身智能形成算力驱动数据加工、数据喂养模型、模型持续消耗算力的三角关系,三者首尾相接构成「数据飞轮」。这一飞轮天然存在「鸡生蛋」难题:模型需要好数据,好数据又需要更强的模型。
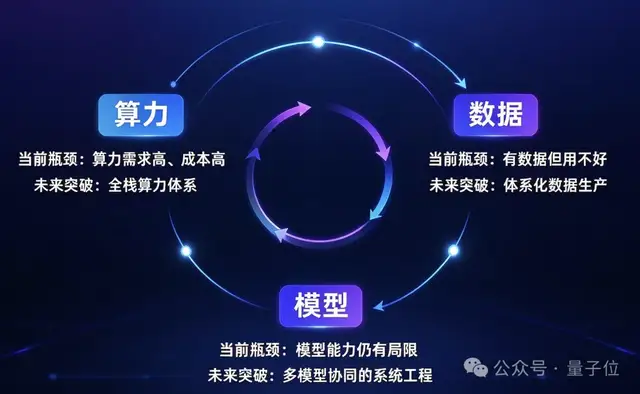
由此,具身智能的数据问题从「怎么多拿数据」转向「怎么让算力、数据和模型真正循环起来」。当机器人数量从几十台增至几百台、几千台,且真机、仿真、视频、点云和动作数据同时涌入时,飞轮如何转动才能持续保障模型迭代速度?
9月23日,在「2026云栖大会」具身智能论坛上,几个行业判断逐渐集中:要让「数据飞轮」真正向前推进,需要一套覆盖数据、模型、训练到算力的全栈工程能力。其中数据侧首先要建立完整的「数据产线」,包括采集、存储、清洗、标注、质检与增广、训练评测,以及数据管理和反馈回流七个环节,基本覆盖具身数据从原始素材变成模型能力的全过程。
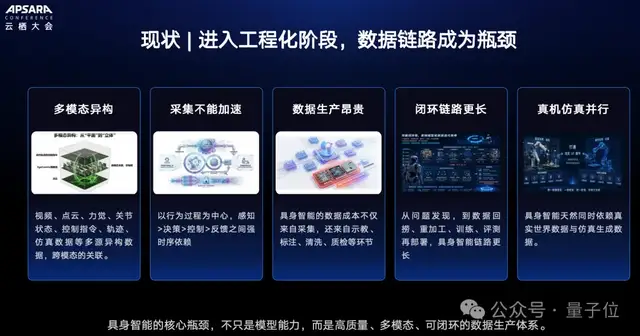
采集需在精度、规模和成本之间取舍,不同来源的数据要统一采集入湖。清洗涉及视频、点云、轨迹等多模态数据的大规模处理。具身数据更为复杂:一段机器人操作视频往往需要识别动作发生的时间边界、判断左右手或机械臂归属、理解操作对象、完成动作语义描述,还可能涉及位姿恢复、多视角对齐和复杂动作拆分。因此,现阶段的数据标注越来越依赖模型参与。例如,AutoClip调用Qwen模型实现动作片段自动切分,AutoCaption调用Qwen模型生成语义描述。对于特定场景的高精度标注需求,基于基模加客户数据后训练领域模型,也正在成为提升标注精度的路径。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。