

云栖大会观察:阿里大模型下一阶段怎么打
今年云栖大会的议程安排与往年相比出现明显变化。吴泳铭发言后,首位登台的是千问大语言模型负责人刘大一恒,随后是负责视听等多模态模型的ATH技术副总裁郑波,之后才是平头哥高慧与阿里云CTO李飞飞。芯片和云依然是阿里绕不开的底牌,投入不会减少,但市场当下更关心的是阿里的模型走向:往哪走、做多大、能不能打。
过去一年多,业内对Scaling的质疑不断,但到2026年年中,风向已明显调转。Anthropic CEO Dario Amodei在摩根士丹利会上定调:Scaling没有撞墙,2026年还会迎来一轮激进加速。Fable 5被行业估算为约4.5-5万亿参数,Kimi K3总参数达到2.8万亿。今年8月,Qwen3.8发布,参数达到2.4T。刘大一恒在云栖大会演讲中给出模型规划路线图:Qwen4系列即将到来,之后的Qwen4.5和Qwen5计划进一步迈向5T—10T参数。
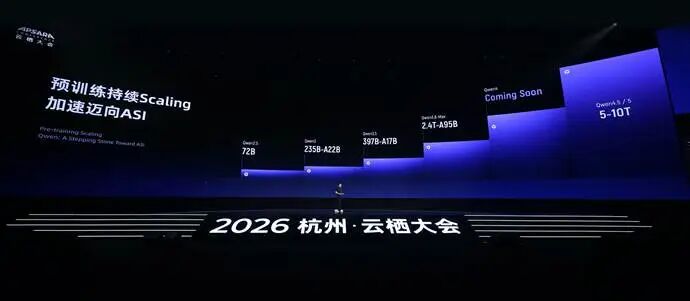
两年前,Qwen2.5旗舰模型参数量为72B;到Qwen3.8已扩大至2.4T,增长33倍。若Qwen4.5和Qwen5继续迈向5T—10T,千问参数规模还将在现有基础上再扩大一倍至三倍以上。刘大一恒明确,基础模型的智能上限仍离不开算力、数据和模型规模的持续投入,阿里会继续扩大预训练计算量,沿Scaling Law向上走。但模型越大,训练和推理成本越高。阿里的解法是一边扩大规模,一边重新设计模型架构。Qwen3.8-Flash已展示这条路线:通过稀疏注意力、线性注意力和外接记忆等新架构,每次推理只激活6B参数;相比上一代,训练成本降至九分之一,百万Token输入价格降至四分之一,超长上下文预填充吞吐量提高8.6倍,模型能力反而继续上涨。这意味着阿里下一阶段的Scaling不只是把模型做得更大,而是用更低成本支撑更大模型继续向前。
规模之外,Qwen4、Qwen5还要等多久,是另一个问题。模型竞争节奏越来越快,一个版本领先很难形成长期优势,真正重要的是谁能更快产生下一代模型。让模型参与造模型,成为越来越被认真对待的方向。一旦模型能帮助研究人员设计实验、分析结果、改进训练方法,下一代模型研发就有机会更快;更强的新模型接着做这些工作,便可能形成一轮轮加速循环,这也是RSI(递归自我改进)今年受到前沿实验室集中关注的原因。Anthropic、OpenAI已开始有具体成果。Anthropic曾给Claude一段训练小模型的代码,让它自己找办法提速,去年Claude把代码提速到原来的3倍,今年最新模型已能做到52倍,而人类研究员花上半天通常只能做到4倍左右。OpenAI则训练了专门攻击其他模型的GPT-Red,不断诱导模型犯错,再用攻击样本训练下一代GPT,结果是GPT-5.6面对最难的一类提示注入攻击时,失败率比四个月前的模型低约六倍。回到阿里大模型,想了解Qwen4、Qwen5何时到来,或许也可以从阿里在RSI上的研究进展里找线索。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。