

代码造世界,扩散绘现实:AgentGarten让智能体在实时试炼场中边玩边进化
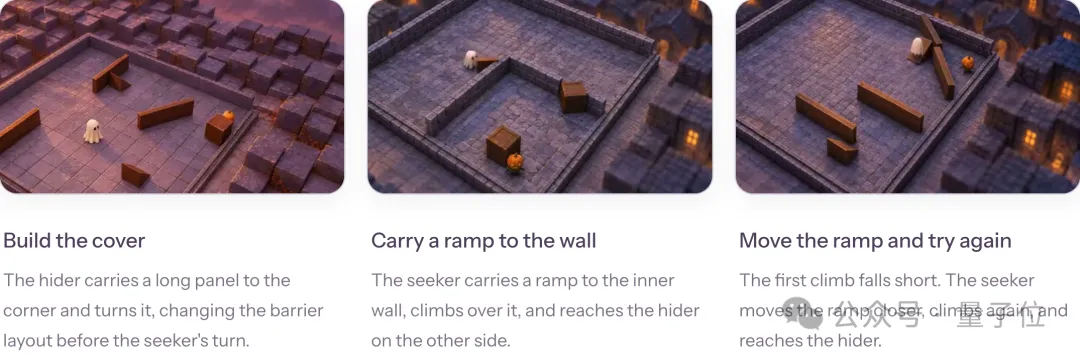
推开一块挡板,通道就此封闭;搬来一段坡道,高墙便有了越过的可能。
每一次行动都会改变世界,而改变后的世界,又成为智能体下一次决策的起点。
当这样的世界可以由代码构建、由扩散模型实时绘出,AI便拥有了一座可以反复探索的「试炼场」:亲自行动,观察后果,验证猜想,再把经验带进下一轮。
这是MirroS团队最新发布的AgentGarten。它将可执行的代码环境与实时神经渲染器连接起来:代码定义物理规则,模型生成视觉反馈,以超过30 fps的吞吐,让智能体持续与世界交互。
在经典的捉迷藏实验中,变化很快发生了。躲藏者在第4轮学会搬动挡板搭建掩体,搜寻者在第10轮掌握借坡道翻墙。一次跳跃失败后,搜寻者还会主动推近坡道,调整位置,再次尝试。
推动这些策略演化的,是智能体自己写下的「实验手册」。
每轮结束,它们复盘尝试、记录发现、标注疑问;下一轮,再带着这些经验继续探索。
代码让世界可以运转,实时渲染让世界可以被看见,持续演练让经验不断积累。
AgentGarten将三者接成闭环,探索一个更大的问题:
当智能体拥有可以行动、试错并积累经验的世界,智能将如何在其中持续进化?
全文Blog:https://mirros.ai/blog/worlds-for-evolving-agents 技术报告:https://mirros.ai/report/agent-garten.pdf 代码:https://github.com/MirroS-Lab/AgentGarten 项目主页:https://mirros-lab.github.io/agent-garten
想让AI真正理解物理世界,光靠给它看海量视频是远远不够的。就像学游泳不能只看录像一样,智能体必须亲自“下场”,即采取行动,观察实际结果,再决定下一步。
这就需要一个具备物理因果确定性的环境,推开的箱子必须留在原地,封堵的通道必须不能通行,后续的一切动作都要被这些物理变化持续约束。
传统的代码/游戏引擎环境,状态精准、规则透明,每一次物理碰撞都清清楚楚。
但短板在画面:程序化搭建的场景往往只有粗糙的几何白模和重复贴图。要想让成百上千个开放场景都拥有逼真的光影质感,所需的美术建模和工程投入是个天文数字。
以视频生成为核心的世界模型(如各类视频大模型),固然能生成令人惊叹的高清画面,也能随动作生成后续帧。
但问题在于,物理信息完全隐式藏在神经网络的记忆中,无法提供一个可查询、可干预的明确状态。你想查看杯子里还剩多少水、想让机械臂拧紧螺丝、或者制定一套严格的任务裁判规则,在单纯的视频黑盒里寸步难行。
MirroS的解法表现为:让两者各司其职,物理交给代码,光影交给神经模型。
在AgentGarten中,一次标准的交互闭环是这样运转的:
智能体给出动作指令;代码环境立即计算物理碰撞与状态更新,并从智能体的第一人称相机视角,导出一份轻量的“几何草图”(即空间深度或表面法线);
随后,神经渲染器读取这份几何草图,结合此前的视觉记忆,瞬间渲染出拟真的下一帧画面递给智能体。
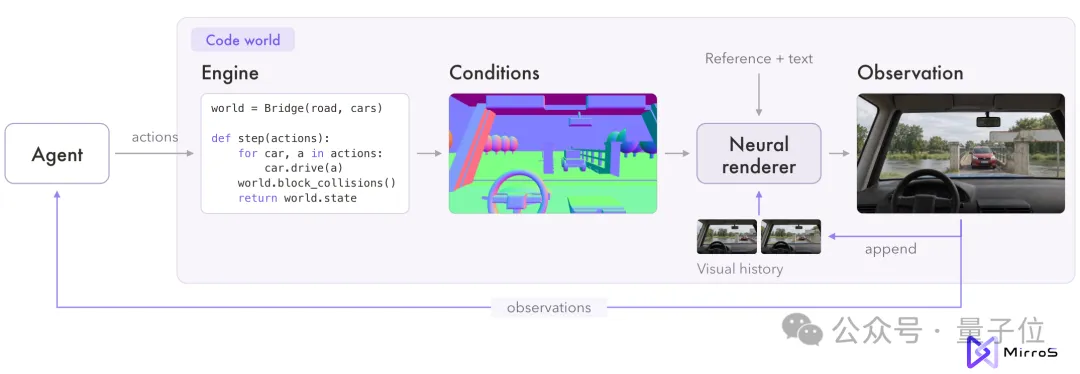
△图2|代码环境与神经渲染器的闭环流转。智能体发出动作指令,代码世界更新状态并导出几何条件,神经渲染器实时生成下一次视觉观测。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。