

蚂蚁数科发布决策模型LingDT-Decision-1.0,综合评分超过微软Jev
10月22日,蚂蚁数科正式发布决策模型 LingDT-Decision-1.0。该模型面向快速决策场景打造,处理结构化决策任务时准确率更高、响应更快、Token 成本更低,尤其适用于产业 AI 场景。模型提供 4B 和 27B 两个版本,目前已在蚂蚁数科 DTMaaS 平台上线,开发者可限时免费体验。
据蚂蚁数科团队在客服、风控、金融等真实业务场景的测试,处理同样任务时,LingDT-Decision-1.0 相比大语言模型可将 Token 消耗降低超 90%,响应时效提升 10 倍,性能表现也更优。该模型首创支持原生多选与按序决策能力,更适配企业真实应用场景。在 23 项开源评测基准中,其综合评分超过 Microsoft-Decision-1、Jev 1.13. 等热门决策模型,27B 版本在同参数模型中取得最高准确率。
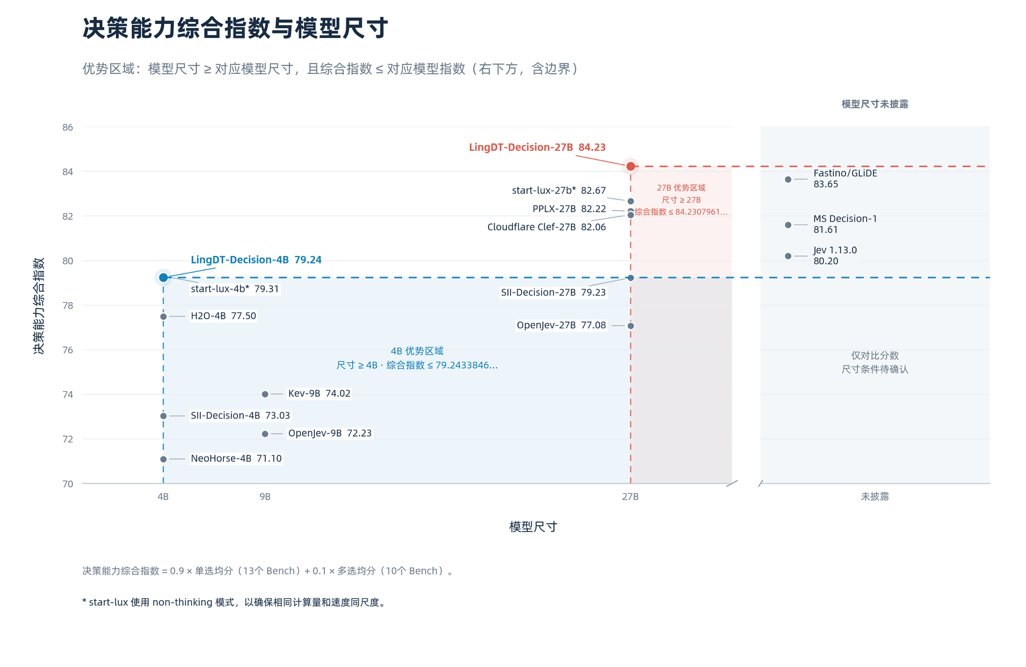
(图注:LingDT Decision 的4B/27B 版本的优势区域,覆盖了相关尺寸包括Jev、MS Decision、GLiDE等决策模型,表现出极强的综合性价比)
专为决策任务设计,Token消耗直降超90%,更快更准
企业实际应用中存在大量高频决策类任务。以客服场景为例,收到“这个订单已经三天了还没发货,请尽快处理”的问询后,AI 需快速完成一系列判断:问题类型(退款、催单还是投诉)、工单紧急度、归属部门以及是否需要人工接管等风险判断。传统大语言模型需逐字(Token)推理再生成输出文本,链路长、成本高,也更容易出错,性能不够稳定。决策模型则不以生成文本为目标,而是做出快速、准确的判断,天然适合意图判断、工具选择、规则分类和结果打分等高频决策型任务。
LingDT-Decision-1.0 目前已在蚂蚁数科的智能客服、安全风控、金融应用等真实业务场景展开测试。其核心思路是将大模型从“先生成结构化答案、再做后续解析”转变为“在限定选项中直接做判断”,从而减少输出不稳定带来的格式问题,简化解析和校验流程。具体表现包括:
- 数据标注场景中,相比 DS-V4-flash,Token 消耗降低约 97%,处理时效提升约 10 倍;
- 智能客服场景中,相比 Qwen-3.7-flash,Token 消耗降低 90%,处理时效提升约 1 倍,风险识别准确率由 76% 提升至 89%;
- 金融应用场景中,意图识别、工具调用、幻觉检测等任务处理时效提升约 5 倍,工具组合完全匹配率提升约 2.6 倍,幻觉召回率由 44% 提升至 70%。
综合来看,该模型在多个真实场景中稳定体现出成本更低、响应更快、判断更准的优势,并能以一套模型适配多类判定任务,接入更简单、维护更省力,便于在不同业务场景中复用和推广。
相比其他决策模型,LingDT-Decision-1.0 更强调面向企业真实应用场景打造。除判断、单选、分类、评级等基础能力外,该模型还首创原生多选与按序决策(DAG)功能,以适配企业业务中复杂、多步骤的决策需求。企业场景中更常见的并非“选一个”,而是“识别一组要处理的事项并按顺序执行”。例如用户提出“我要退款、关闭续费、补开发票,但不要注销账号”,单选往往只能识别“退款”这一主诉求,容易遗漏其他需求;多选能一次识别所有诉求,按序决策还可进一步判断:退款需先核验,关闭续费可先执行,发票处理可能要等退款结果。原生多选能力允许一项任务同时命中多个候选,适配多标签识别、复合意图和工具组合等需求;按序决策能力则能按照任务之间的依赖关系完成多步决策,更贴近金融、风控、客服等真实业务流程。
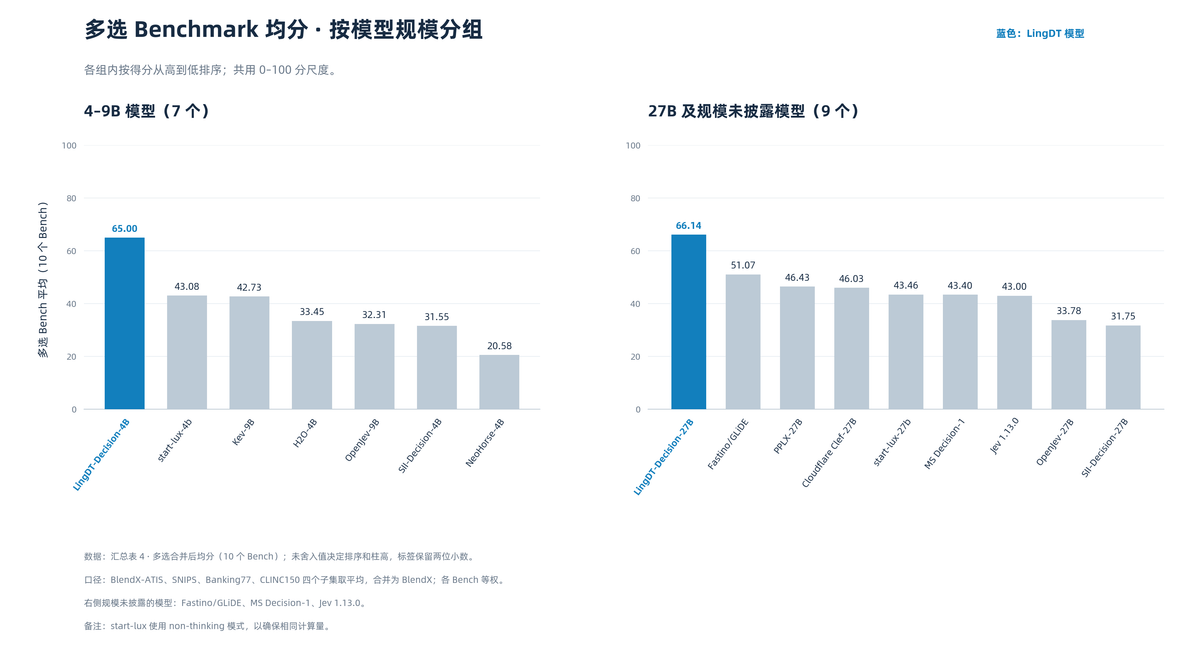
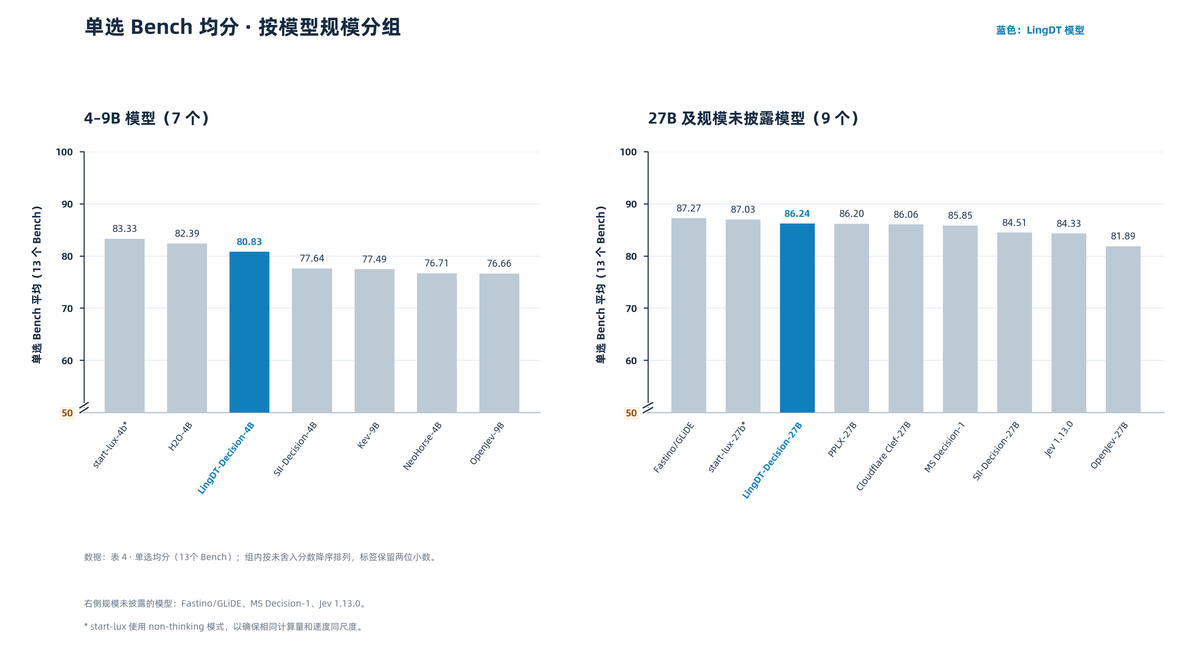
覆盖 23 项主流开源评测基准的测试结果显示,LingDT-Decision-1.0 的 27B 版本综合评分(90%×单选评分+10%×多选评分)位居第一,准确率超过 Microsoft-Decision-1、Jev 1.13.0、Fastino/GLiDE 等热门决策模型。其中,在多选任务上,4B 和 27B 版本的准确率表现超过 Microsoft-Decision-1、Jev 1.13.0、Star-lux 等 16 个决策模型,体现出原生多选能力在多标签与组合判定任务中的优势;在单选任务上,该模型位居第一梯队。
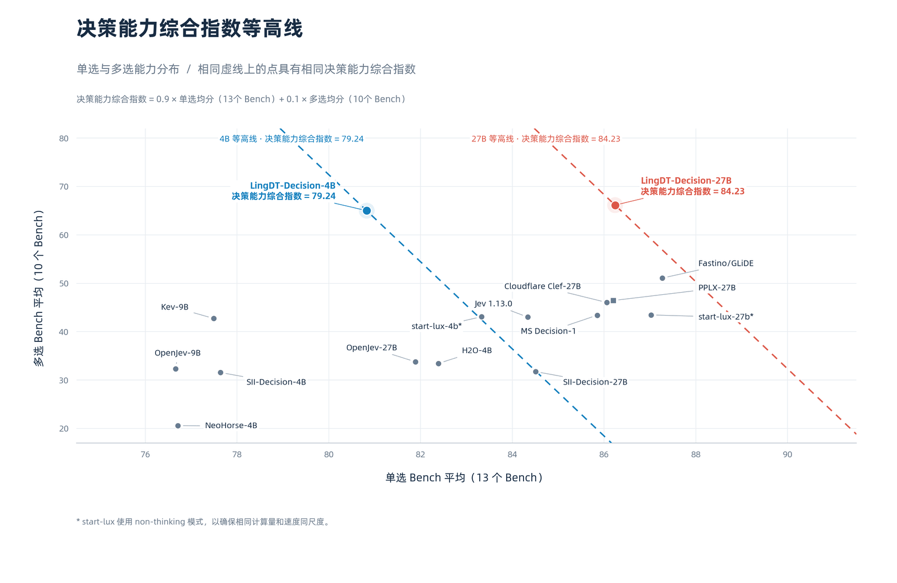
(图注:通过单选/多选能力的2维图展开 体现了LingDT Decision 4B/27B 在单选&判断能力 属于Tier-1 超越绝大多数同尺寸模型;而“原生多选能力”断档式领先)
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。