

硅基流动唐安波:用Token生产力公式,帮央国企把大模型真正用起来
在由企业网D1net主办的2026秋季央国企CIO及数科公司高管峰会(第19届)上,硅基流动解决方案总监唐安波发表主题演讲,题为《从“算力”到“Token生产力”:央国企大模型规模化落地的推理基础设施与ROI实践》。
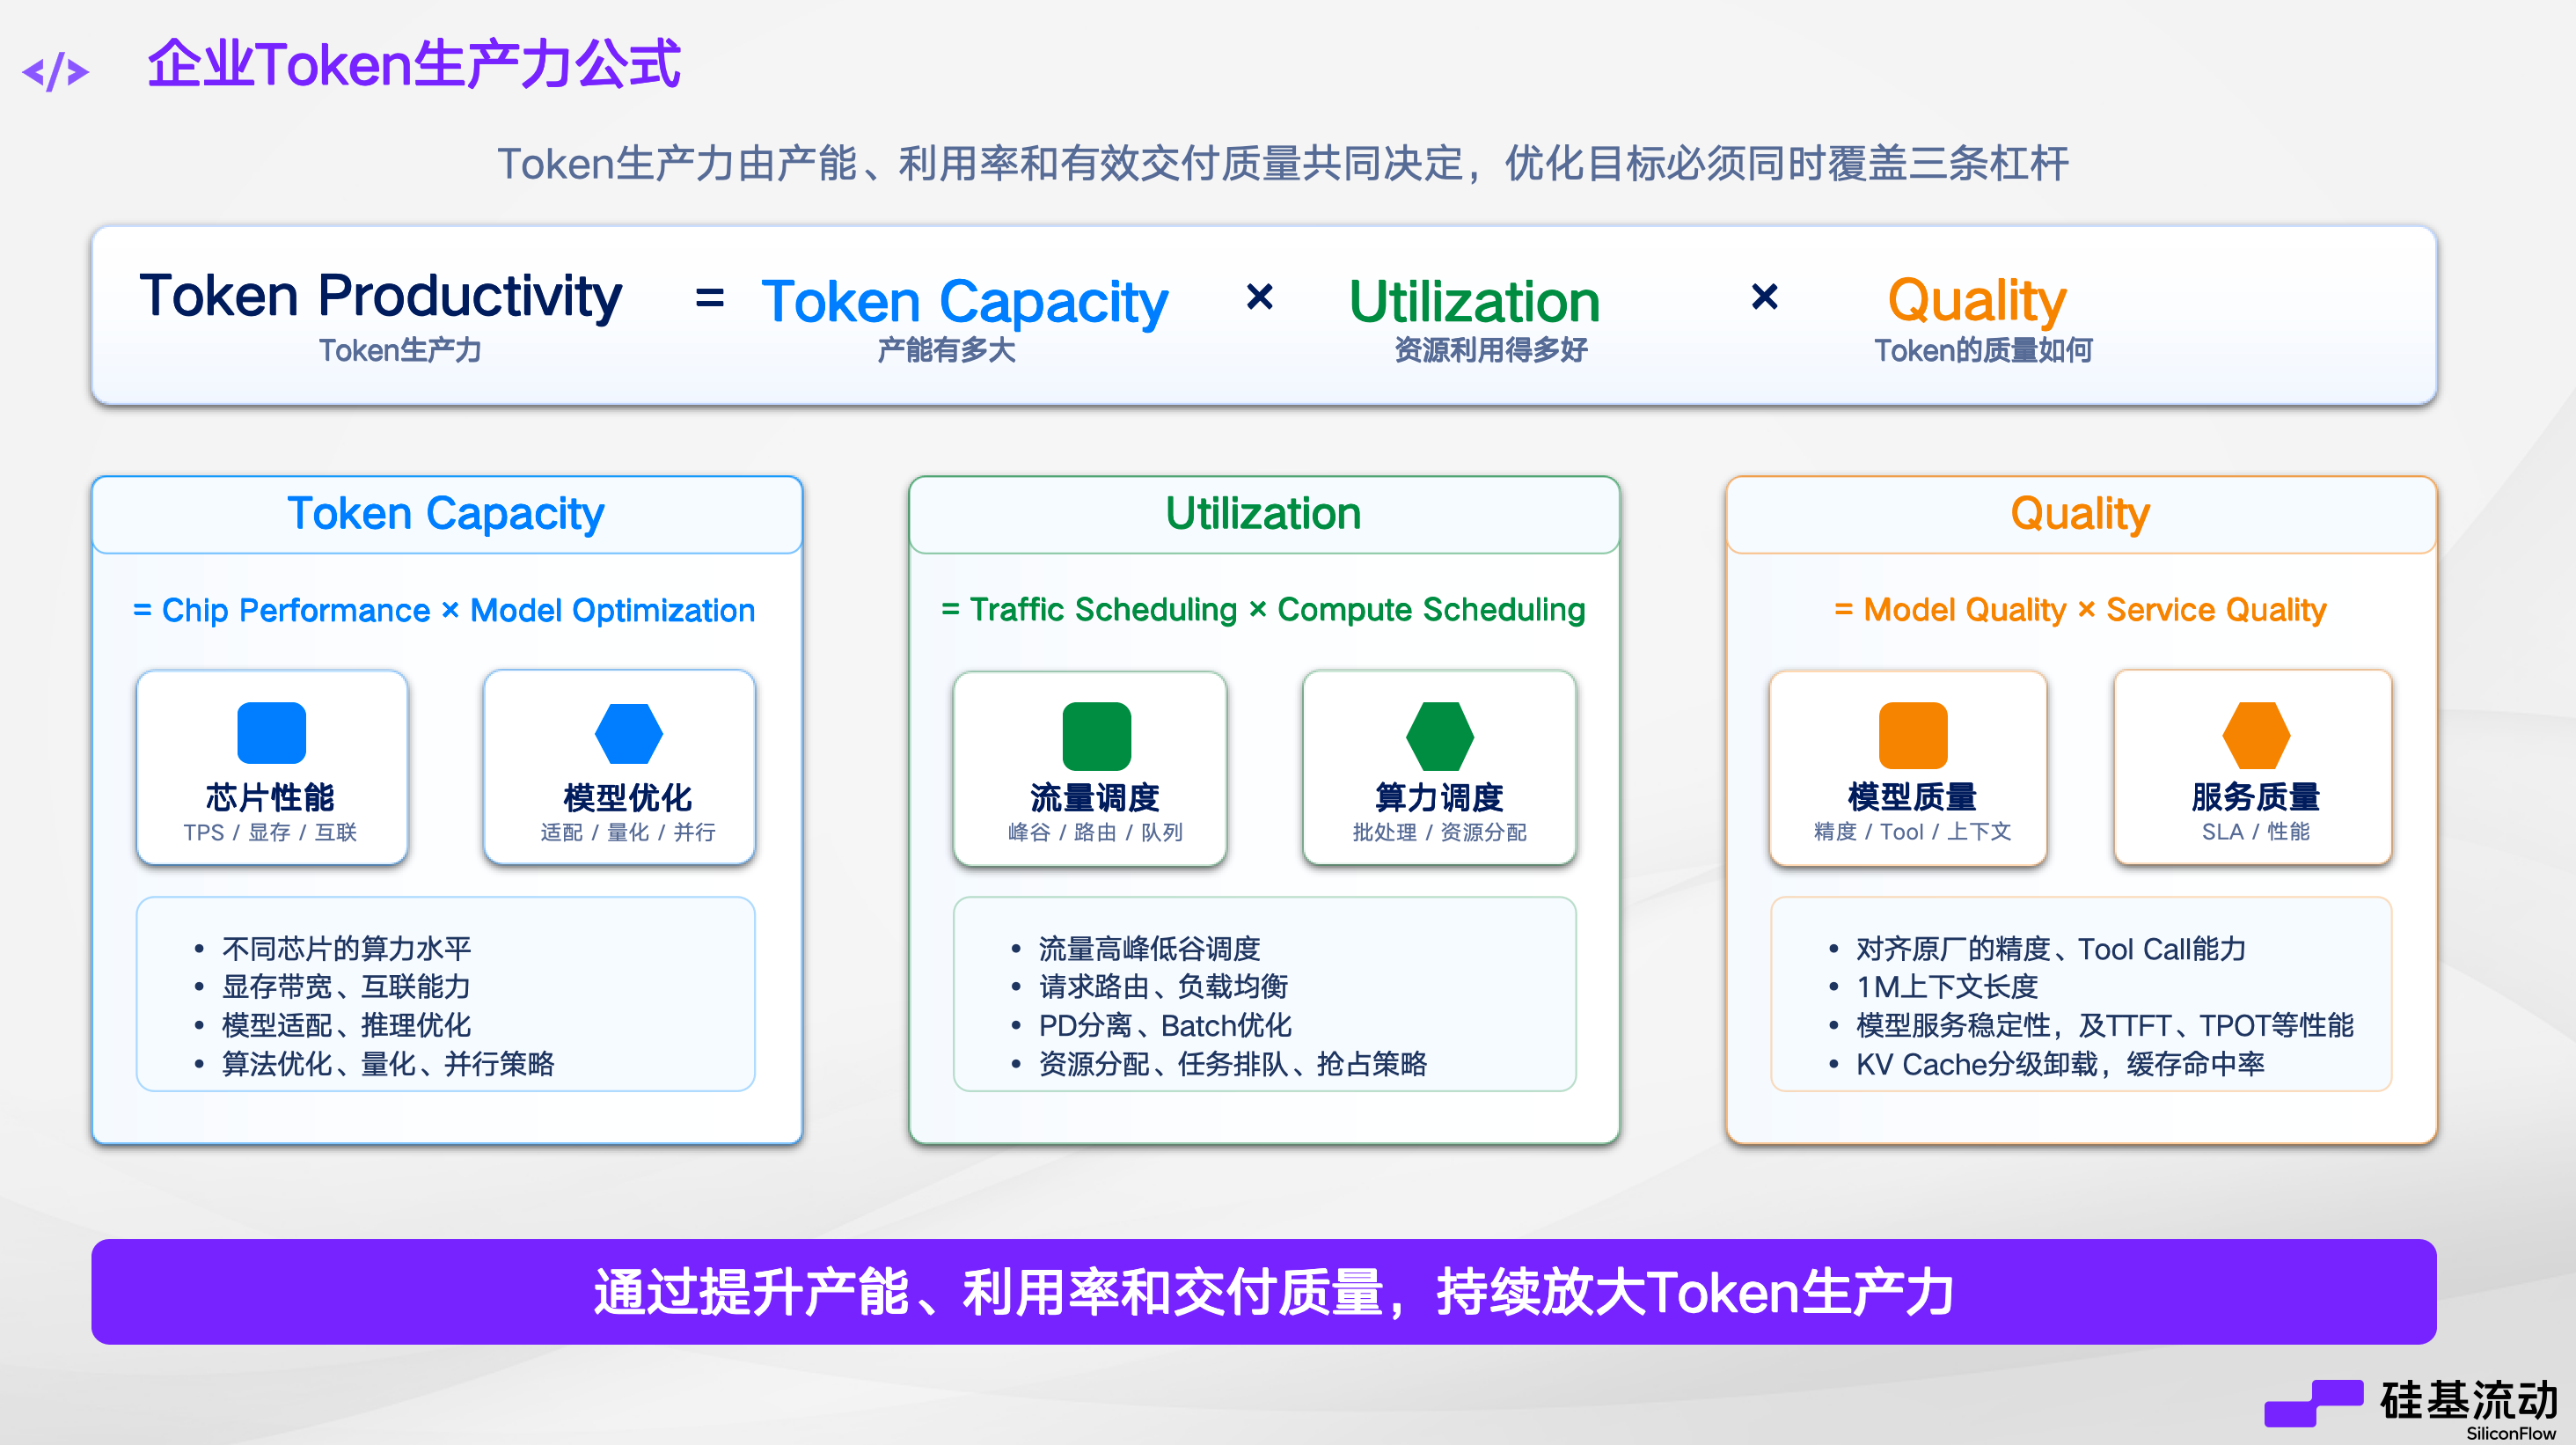
唐安波指出,当前AI应用处于爆发增长早期,Token消耗量呈指数级上升。模型架构与算力架构相互推动、持续迭代,企业既要适配变化,又要为业务场景提供多元模型服务并控制成本。硅基流动的定位是打通算力到Token的转化层:统一纳管算力,通过自研推理引擎提升模型运行效率,既在公有云建设Token工厂,也帮助央国企在内部构建Token工厂。基于系统化推理工程,硅基流动提出Token生产力公式:Token生产力 = 产能 × 利用率 × 交付质量。产能由芯片硬件能力与模型优化水平决定;利用率依靠流量治理与算力智能调度;交付质量涵盖推理精度、工具调用等任务成功率以及生产环境SLA稳定性。
在架构层面,硅基流动从业务与流量视角设计了四层解耦架构,连接模型运营、模型运维、推理执行与算力调度,覆盖模型部署、加速到服务调度全生命周期,可适配央国企已有平台、避免重复建设。模型网关面向使用方完成计量、计费、鉴权,并支持按响应时间、性能优先、成本优先等策略进行调度路由;模型服务平台管理模型上下架与模型仓库,已适配近百款模型,支持一键拉起;高性能推理框架围绕具体模型与硬件自研算子库、通信库。合作案例包括:与华为云推出基于国产芯片的DeepSeek R1/V3 Token服务,在CloudMatrix超节点集群上实现DeepSeek-R1单卡Decode吞吐超1,920 tokens/s;全球首发基于沐曦曦云C550集群的Kimi-K2商业化服务部署;在摩尔线程MTT S5000芯片上部署DeepSeek-V3,单卡Prefill吞吐超4000 tokens/s、Decode吞吐超1000 tokens/s。推理技术持续演进,涵盖算子优化、通信优化、模型量化、PD分离及KV Cache分级卸载等。算力调度方面,弹性扩缩容与运营手段配合,例如分时定价引导夜间业务,并基于请求队列、性能等指标动态调整模型实例。
案例方面,某央国企集团原有约50台机器供下属分子公司申请部署模型,模型实例达四五十个但算力利用率低。硅基流动与客户协同重构:将重复模型收敛至约十个,把按机器分配改为Serverless模型服务、统一API调用。同样约50台机器得以承载更多任务,腾出多台部署GLM-5.2、DeepSeek-V4-Flash-0731等大参数模型,结合性能优化使更多场景从“不可用”变为“可用”。新模型上线后,单并发到较多并发测试中输出速度综合保持30 tokens/s以上,相同模型对比测试取得40%~100%性能提升。模型吞吐与算力利用率双提升后,原先一个Qwen模型每百万Token成本从一百多元降至十元以下。唐安波表示,进一步提升ROI需要应用与基础设施共同优化。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。