

记忆张量开源MemT 1.0,记忆原生模型首次完成近300B参数验证
AI领域近期把注意力集中在RSI(自我改进)上。Hinton的RSI论文共有22位署名作者,其中包括Bengio、OpenAI首席科学家Pachocki、Anthropic联合创始人Jack Clark等。关注AI自我改进的同时,一个基础问题随之浮现:有效方法需要被保留,走过的弯路也需要被识别,承接这一职能的正是记忆。
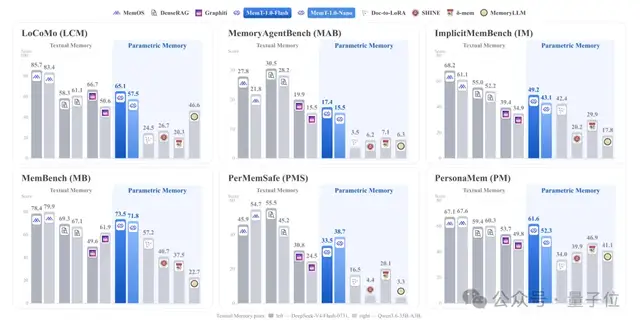
常见做法是给AI外接一个经验库,用于保存和检索操作方法、历史教训。记忆张量选择了另一条路线:记忆原生,把经验的保留、更新和调用做成模型可学习的能力,使记忆在模型中内生,形成记忆原生模型。其最新开源的MemT 1.0系列给出了一条具体路径:将经验编码为内部动态状态,通过训练学习如何写入、更新和读取,再让这些状态经由记忆分支参与后续计算。与外部记忆相比,该方案能力没有打折,未来拓展空间也更大。这也是记忆原生模型首次完成近300B参数规模的工程验证。
(论文地址:https://arxiv.org/abs/2610.26825)
- MemT-1.0-Nano:总计36B参数、激活3B,基座为Qwen3.6-35B-A3B。
- MemT-1.0-Flash:288B参数、激活17B,基座为经过进一步后训练的DeepSeek-V4-Flash。
两款模型的共同变化是,在选定的Transformer模块中增加了一条与原有注意力并行的记忆计算通路。
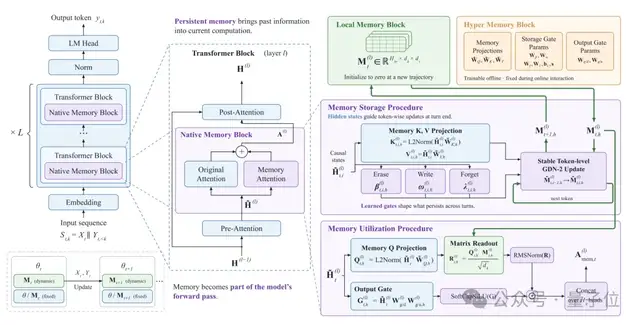
以面对新任务为例,外部记忆的做法是将记忆原文、检索证据乃至抽象方法放回上下文,让模型复用经验,检索与整理过程也可引入学习机制。MemT 1.0这类记忆原生模型则深入模型内部:经验经编码成为可更新的矩阵状态;模型生成答案或动作时,由专门的记忆分支读取状态,读出结果与原有注意力输出融合,进而影响后续生成。两者的区别在于经验如何表示,以及通过何种计算过程发挥作用。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。