

DeepSeek开源推理框架,同周AI算子性能反超
国产大模型的竞争已从模型层延伸到算力层。模型最终要依托算子在芯片上执行,同一模型与芯片搭配更优算子,有时能带来数倍性能提升。算子效率直接决定显卡运行速度与每个token的成本。
DeepSeek近日全面开源推理框架DeepInfer。继模型权重及FlashMLA、DeepGEMM等算子库后,这次把模型运行链路也开放了。其中FlashMLA经工程师在芯片上逐行手调,算子性能达硬件极限的90%以上,这是人类手工在部分芯片上目前达到的极限成绩。
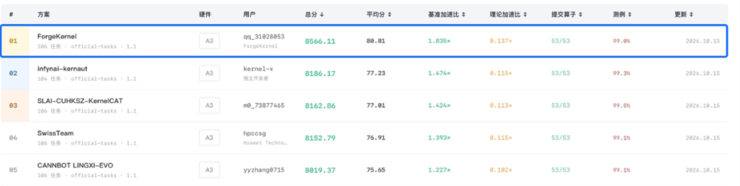
这一极限在同一周被AI刷新。截至10月22日,完全由AI编写算子、无人工逐行调优的ForgeKernel同时登顶两个算子评测榜:英伟达主场的SOL-ExecBench FlashInfer-Bench合集第一,以及昇腾CANN官方仓库维护的CANNBench A3硬件榜第一,基准加速比1.835×,领先第二名25%。在DeepSeek v4.1 Flash的算子上,相比DeepSeek开源的英伟达版本,ForgeKernel通过从0用AI迭代的方式实现了性能超越。
DeepSeek的开源,算子优化榜单上的激烈竞争,最终都指向同一方向:让国产智能在每一块芯片上都跑得更快。
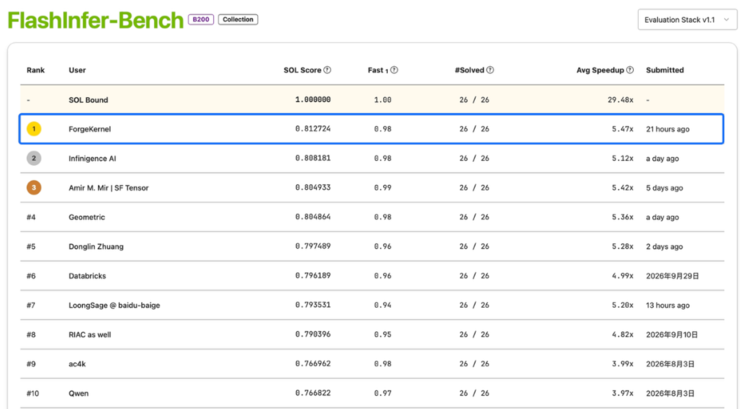
英伟达 SOL-ExecBench FlashInfer-Bench
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。