

字节否认用15万群演数据训练大模型,称传言严重失实
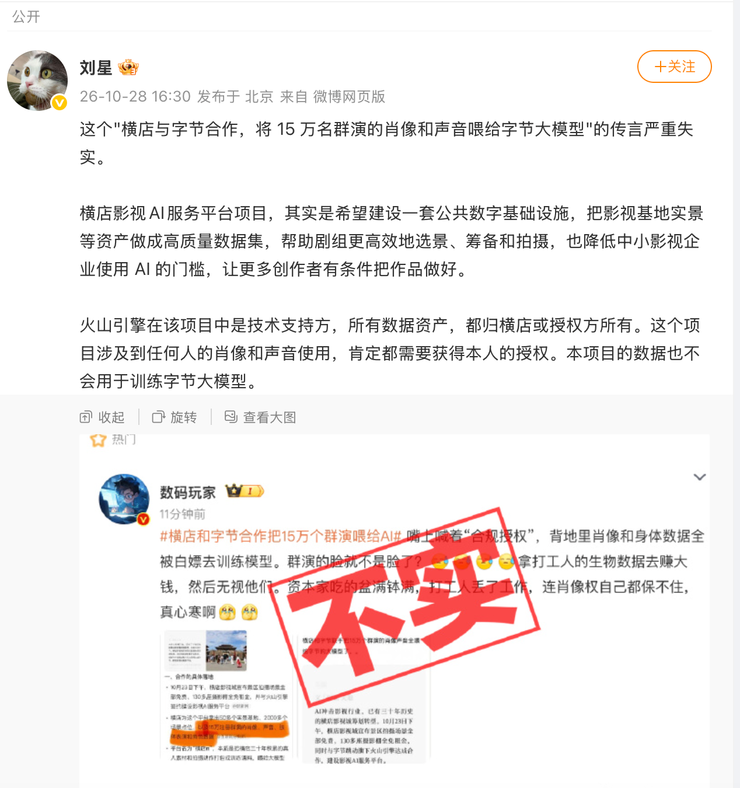
网络流传“横店与字节合作,将15万名群演的肖像和声音喂给字节大模型”。字节豆包公关负责人刘星通过微博回应,称该传言严重失实。
据其介绍,引发讨论的项目实为横店影视AI服务平台建设项目,初衷是建设影视行业的公共数字基础设施,将影视基地实景等资产做成高质量数据集,帮助剧组更高效地选景、筹备和拍摄,同时降低中小影视企业使用AI的门槛。
刘星就该项目作出三点说明:
- 火山引擎在该项目中仅是技术支持方,所有数据资产均归横店或授权方所有;
- 项目中涉及任何个人的肖像和声音使用,均需获得本人授权,不存在未经授权采集的情况;
- 本项目所采集的数据不会用于训练字节大模型。
公开资料显示,横店影视AI服务平台建设项目目前处于中标阶段,将围绕影视行业数据集建设、配套技术平台等业务展开。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。