

面壁智能ForgeKernel直播22.5小时,算子性能超DeepSeek手写9.8%
今早,一个名为ForgeKernel的无人参与Agent在直播中完成了对DeepSeek最新核心算子的超越:在未参考DeepSeek原始实现的情况下,将算子性能提升了9.8%。
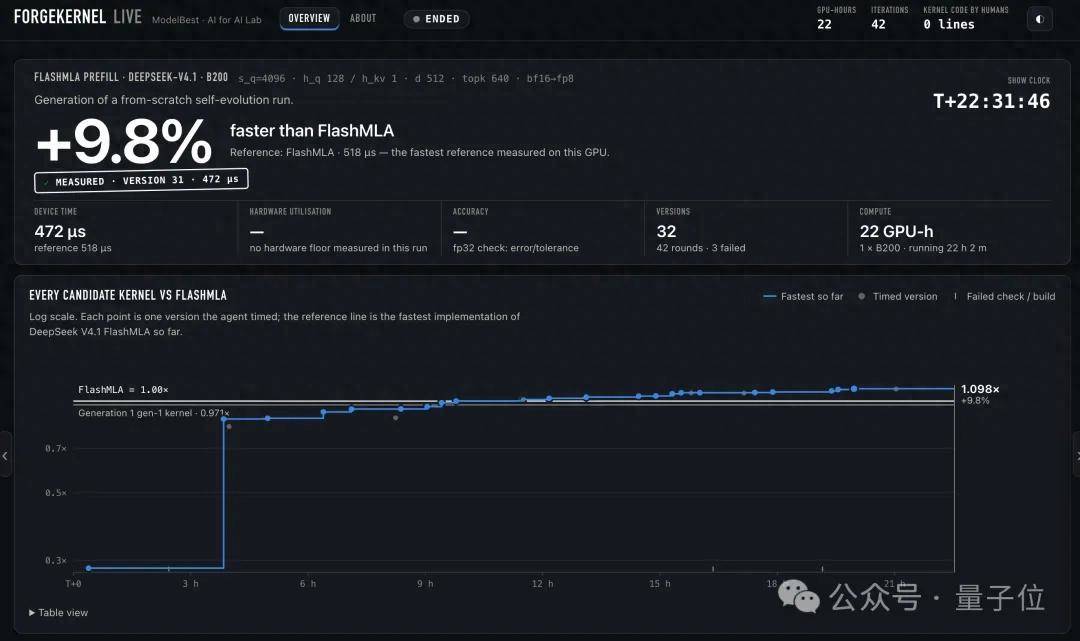
整场直播历时22.5小时,从算子设计角度看耗时较短,吸引了不少网友围观:
- 直播内容为Agent在英伟达B200上挑战DeepSeek-V4.1的FlashMLA Prefill算子
- FlashMLA是DeepSeek开源的注意力核心算子库,10月20日开源的推理框架DeepInfer也已将其集成
- 该算子出自业内公认Infra最强的团队,被视为人类手写算子的巅峰
- AI仅获得算子的数学定义与目标硬件约束,从零开始通过自进化逐轮改进
22.5小时里,每一次改写和性能数字的变化都实时呈现在观众面前:全程42轮迭代,留下32个版本,使用1张B200和22个GPU小时;人类为该算子编写的代码为0行。
手写巅峰就这样被一份人类未写一行代码的算子越过。该算子生成系统来自面壁智能,直播结束后,智能进化实验室联合OpenBMB社区宣布将其开源。
ForgeKernel并非首次亮相。10月27日,昇腾CANN官方发文点名ForgeKernel,其同时登顶CANNBench 950DT、950PR、A3三大硬件榜单。
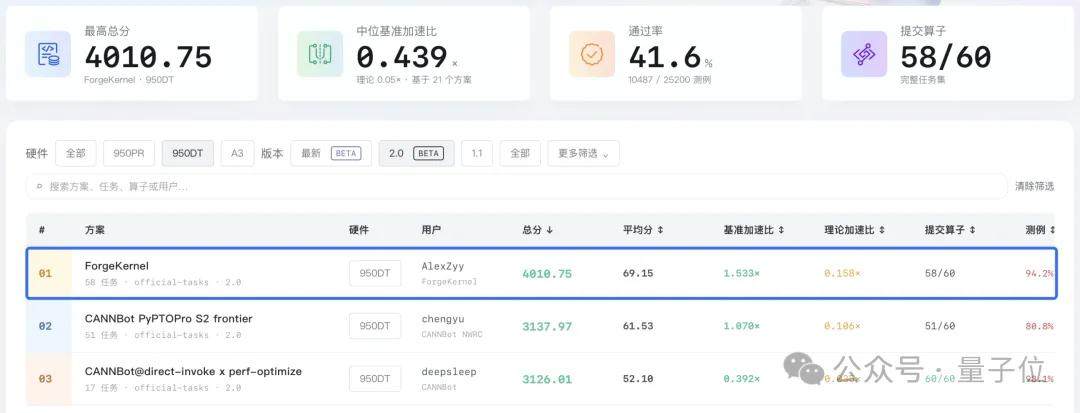
在950DT榜单上,ForgeKernel以4010.75分排名第一,领先第二名27.8%;基准加速比1.533×,约为第二名的143%。同等硬件投入下可用算力增长接近50%,企业算力采购与部署成本可相应降低约一半。950DT是新一代芯片,配套算子库尚在建设初期,人工适配周期长,ForgeKernel率先完成适配并登顶,表明新硬件上市后AI能快速产出高质量算子,芯片从上市到适配好的空窗期正被大幅压缩。
950PR是三张榜中竞争最激烈的一张,前三名基准加速比均达到1.3倍:
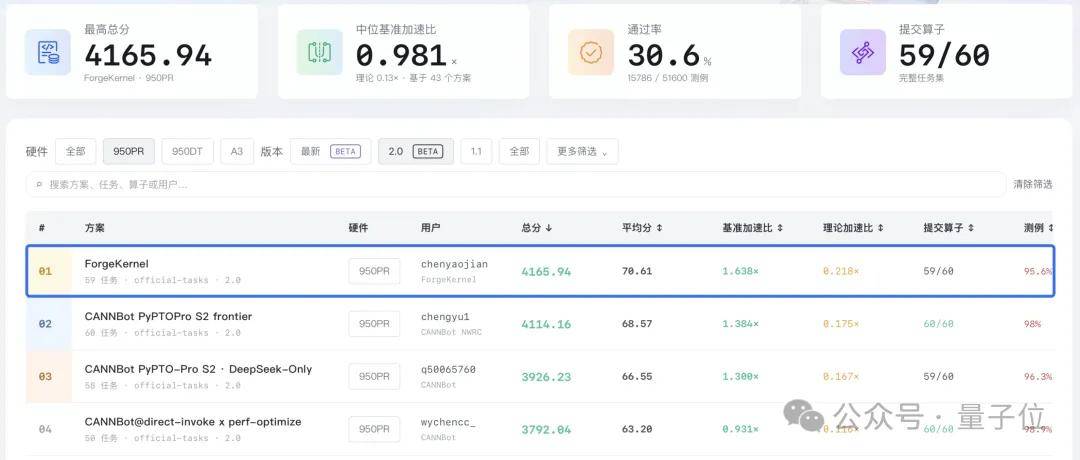
ForgeKernel在该榜总分4165.94,同样排名第一;基准加速比1.638×,约为第二名的1.18倍。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。