

招商局狮子山实验室发布驭物具身推理模型35B-A3B
人类日常的直觉判断,对机器人而言常常是难题。视频中物体看似更高,不代表它在三维空间里位置更高;换个拍摄角度,家具外观变了却仍是同一物体;画面中物体位移,可能来自物体本身,也可能只是相机转动。这些细微的空间与状态变化,人类一眼可辨,机器人的“具身大脑”却难以攻克。视角变化混淆物体身份、误判相机运动、错估任务进度,都会直接导致机器人执行失败。模型不能只“看见物体”,还要读懂三维空间关系、捕捉物体状态变化、研判任务阶段。
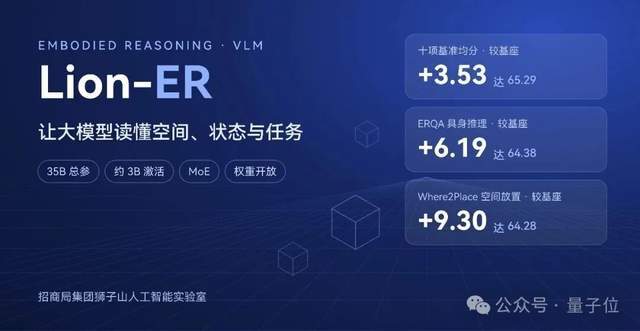
近日,招商局先进技术研究院下属狮子山人工智能实验室发布具身推理视觉语言模型「驭物™ Lion-ER-35B-A3B」。该模型采用MoE混合专家架构,总参数约35B,每个Token仅激活约3B参数。在不显著增加推理开销的前提下,模型在十项主流具身相关基准上全部指标上涨,多项核心能力超越参数量更大的主流模型,走出了一条区别于大规模堆砌训练数据的技术路线,有助于机器人真正理解三维物理世界。
过去几年,Open X-Embodiment、DROID等工作不断拓展真实世界机器人数据的边界。但随着数据规模扩大,一个问题愈发清楚:已有研究表明,在既有机器人数据集内,仅调整不同数据域的训练权重,就能明显影响下游任务表现。「驭物™ Lion-ER-35B-A3B」的核心亮点并非单纯提升参数量,而是搭建了一套能力牵引的具身数据引擎,摒弃盲目收集海量数据的传统做法,围绕模型需要掌握的能力做正向设计,再依靠评测发现短板,闭环迭代优化数据。
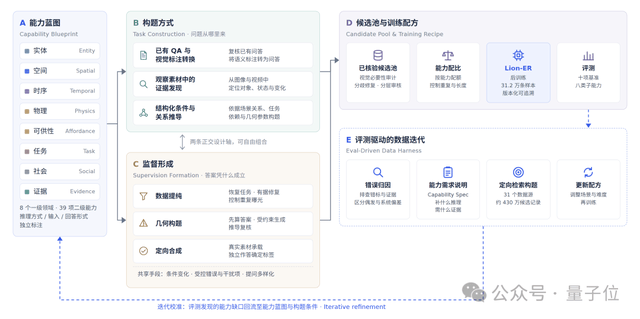
招商局狮子山团队梳理出一张细粒度的“能力蓝图”:将具身推理拆解为“实体、空间、时序、物理、可供性、任务、社会、证据”等8个一级领域,细化出39项二级能力,并把推理方式、输入形式和回答形式作为独立维度分开标注,避免不同分类维度混用造成重叠。蓝图不仅定义模型需要学习哪些能力,还明确这些能力应在何种条件下被调用。真实任务往往涉及复合能力,例如判断物品是否放置到位,既需要任务进度判断,也需要空间关系推理。因此,团队在蓝图阶段就分别记录主能力与辅助能力,把不可拆分的联合任务单独列出。训练采样时,团队还会考虑不同因素的组合与留出,避免某类能力始终绑定在少数固定场景、物体或提问方式上。
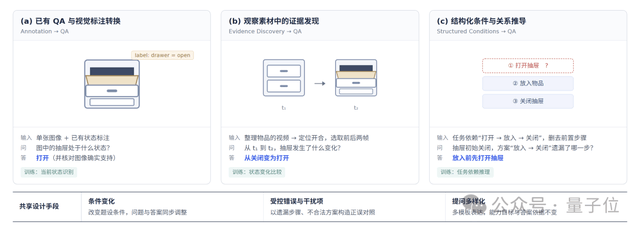
把抽象的能力目标逐项拆解、落地为“需要什么场景、怎样组织观察、提出什么问题、依据什么确定答案”。以跨视角推理为例,首先明确提供给模型的视角数量、需要在多张画面之间建立关联的目标物体,以及判定方位时所采用的观测者位置与朝向。同时还要核验素材本身:模型拿到的视觉信息是否足以支撑可靠答案。如果关键视角缺失、证据不足,这道题就只能依靠猜测,不能纳入合格训练样本。这类构题规范由目标能力本身驱动,不需要等到评测暴露错题之后再被动补充数据。能力蓝图预先规划好需要覆盖的能力范围,评测则承担查漏补缺的角色,后续定位模型依旧薄弱的环节。构题方式层面,团队设计了三条可互相组合的路径:从已有QA与视觉标注中转换、从观察素材中发现证据、从结构化条件与关系中推导。这三条路径共同把抽象的能力要求,转化为一道道具体、可作答的训练题。
本文图片来自互联网,仅供学习交流使用,版权归原作者或原平台所有。如认为图片侵犯了您的权益,请联系我们删除。